2026-07-29
Validación human-in-the-loop: qué es, cómo funciona y cuándo usarla
Respuesta rápida: la validación human-in-the-loop combina sistemas automatizados con criterio humano capacitado. Las personas verifican, corrigen, aprueban o escalan los resultados de las máquinas en los puntos donde más importan la precisión, el contexto, la ética o el riesgo. …
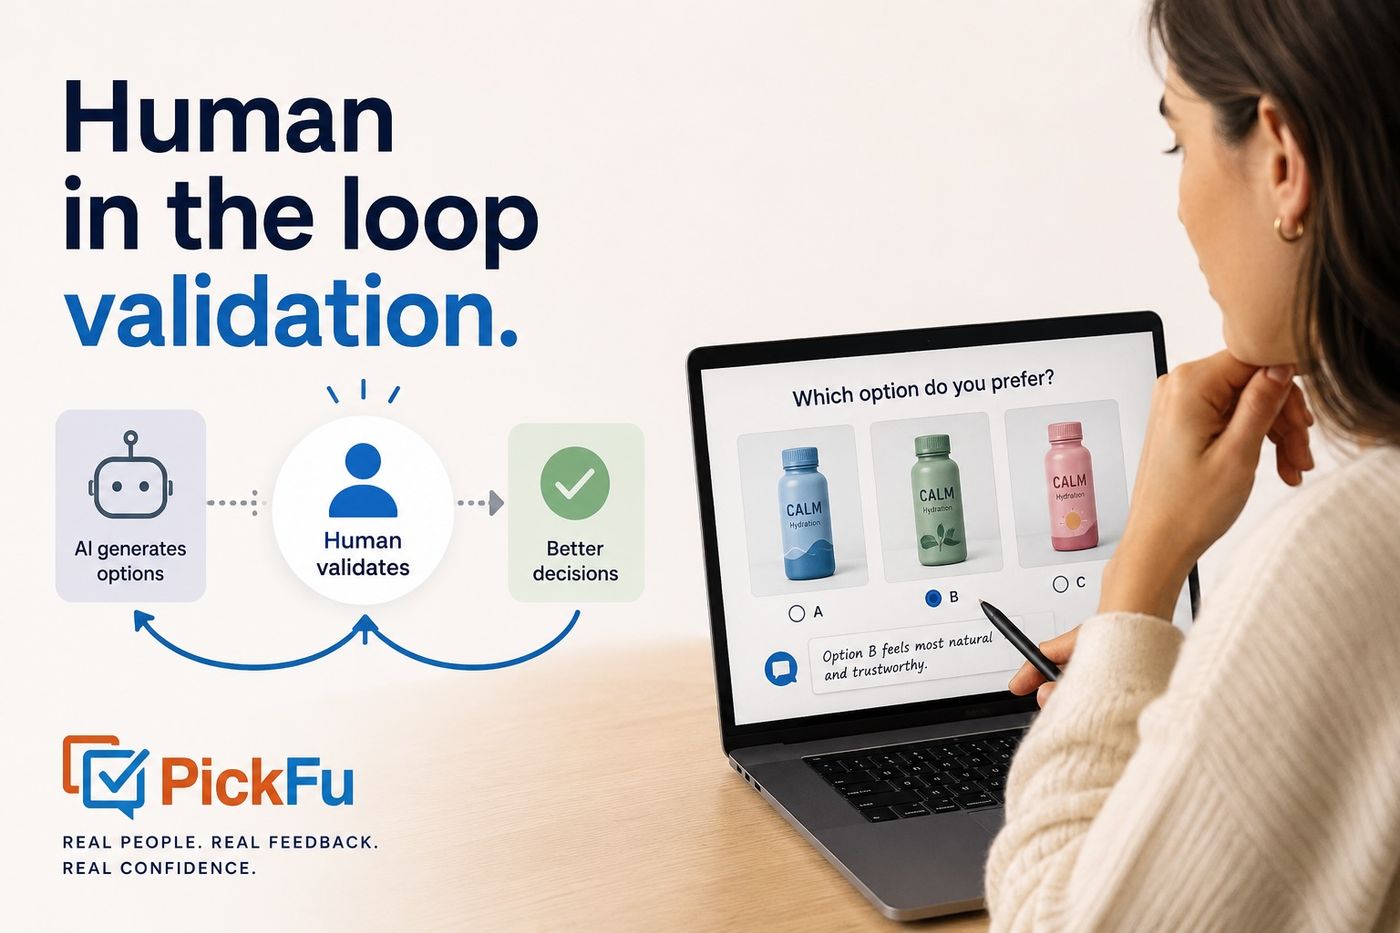
Respuesta rápida: La validación human-in-the-loop (con intervención humana) combina sistemas automatizados con el criterio de personas capacitadas. Esas personas verifican, corrigen, aprueban o escalan los resultados de la máquina en los puntos donde más importan la precisión, el contexto, la ética o el riesgo. Se usa en IA, aprendizaje automático, etiquetado de datos, moderación de contenido e investigación de consumidores para detectar los errores que la automatización pasa por alto y, cuando se hace bien, para devolver esas correcciones al sistema y que mejore. Para los equipos que toman decisiones de producto, diseño y marketing, el paso humano suele consistir en obtener opiniones de personas reales de su público objetivo, que es exactamente para lo que está hecho PickFu.
La automatización procesa enormes volúmenes de datos con rapidez, pero tropieza cuando un caso es inusual, delicado o de alto riesgo. La revisión humana es el paso deliberado que decide si un resultado es lo bastante bueno como para actuar a partir de él. Esta guía explica qué es la validación human-in-the-loop, cómo funciona, dónde ayuda, dónde no y cómo se aplica a las decisiones cotidianas de producto y marketing, no solo a los sistemas técnicos de IA.
La validación human-in-the-loop, a menudo abreviada como HITL, coloca el criterio humano en puntos concretos de un proceso automatizado. Una persona puede verificar la predicción de un modelo, comparar varias opciones creativas, corregir una etiqueta, rechazar una respuesta engañosa o escalar un caso dudoso a un especialista. El objetivo no es sustituir la automatización por trabajo manual. Es decidir dónde la inteligencia humana aporta el contexto, la responsabilidad o la reducción de riesgo suficientes para justificar el tiempo y el costo adicionales.
Para cofundadores y dueños de negocios, esa es una decisión de diseño del sistema. Un flujo de trabajo totalmente automatizado puede ser más rápido y barato. Uno con revisión humana puede ser más seguro y creíble. El equilibrio correcto depende de lo que hace el sistema, de quién puede verse afectado, de lo fácil que sea detectar los errores y de lo que ocurre cuando el sistema se equivoca.
Ese equilibrio importa en las aplicaciones técnicas de IA, y se aplica igual a las decisiones de producto y marketing. Los equipos usan la retroalimentación humana para validar anuncios generados por IA, poner a prueba conceptos de negocio, comparar empaques, evaluar recursos para las tiendas de aplicaciones, revisar respuestas a encuestas y decidir si una investigación generada por máquina refleja lo que los clientes reales creen de verdad. La automatización produce posibilidades. La validación human-in-the-loop decide cuáles se convierten en decisiones.
Ahí es donde entra PickFu. PickFu es una plataforma de investigación de consumidores que pone tus opciones (conceptos de producto, empaques, creatividades publicitarias, nombres, fichas de producto) frente a encuestados humanos verificados de tu público objetivo, con comentarios escritos de vuelta en cuestión de horas. Está hecha para un momento human-in-the-loop muy concreto: la decisión final sobre qué lanzar realmente. La IA generativa puede producir cien variaciones y predecir qué podría gustarle a la gente, pero no puede ser el cliente. Las personas son quienes compran el producto, juzgan la marca y deciden si un diseño se gana un clic. Obtener retroalimentación cualitativa real de personas reales de tu público objetivo es la parte que la IA solo puede emular, y una emulación no es evidencia.
¿Qué es la validación human-in-the-loop?
La validación human-in-the-loop es un proceso en el que las personas revisan, verifican, corrigen, aprueban, rechazan o escalan activamente los resultados producidos por un sistema automatizado. La parte automatizada hace el trabajo que resulta difícil o ineficiente de hacer a mano a gran escala. La parte humana aporta el criterio contextual allí donde las reglas, los patrones históricos o las probabilidades del modelo se quedan cortos.
Piensa en un sistema de atención al cliente que redacta respuestas con un modelo de lenguaje de gran tamaño. Cuando la confianza es alta, las respuestas sencillas pueden enviarse automáticamente. Una respuesta que involucre una disputa por un reembolso, una queja legal o un problema de seguridad se deriva a un empleado para su aprobación. El sistema sigue gestionando la mayor parte del volumen, pero una persona permanece involucrada donde el costo de un error es mayor.
Eso es distinto de pasar cada resultado por una revisión manual genérica. En un flujo de trabajo bien diseñado, la participación humana tiene un propósito definido. Los revisores reciben criterios, señales de incertidumbre, opciones de decisión y rutas de escalamiento, y sus correcciones quedan registradas en lugar de desaparecer en una bandeja de entrada privada.
La validación human-in-the-loop aparece en la IA y el aprendizaje automático, la anotación y el etiquetado de datos, la atención al cliente, la moderación de contenido, la detección de fraude, la evaluación de datos sintéticos, el control de calidad de respuestas a encuestas, la investigación de producto y creativa, los flujos de trabajo legales y sanitarios, el procesamiento del lenguaje natural y la visión por computadora. El hilo común: un sistema automatizado produce o recomienda algo, y una persona decide si es aceptable para el uso previsto.
Validar no es lo mismo que una revisión manual corriente
La revisión manual puede ser informal. Alguien lee un resultado, lo cambia y sigue adelante. La validación es más estructurada. El revisor contrasta el resultado con un estándar acordado y luego lo aprueba, corrige, rechaza, categoriza o escala. Idealmente, la decisión pasa a formar parte de un registro de auditoría que después puede respaldar el aseguramiento de la calidad, los informes o la mejora del modelo.
La distinción importa porque poner a una persona frente a un resultado de la IA no hace que el proceso sea fiable por sí solo. Sin criterios claros, dos revisores llegan a conclusiones distintas. Un revisor apurado aprueba un error. Un experto corrige un resultado en silencio sin registrar por qué falló. El valor surge de combinar la supervisión humana con un sistema repetible.
Human-in-the-loop, human-on-the-loop y human-out-of-the-loop
La participación humana puede organizarse de varias formas. En un sistema human-in-the-loop la persona participa directamente en la decisión, y el sistema puede ser incapaz de completar ciertas acciones sin aprobación humana. En un sistema human-on-the-loop (a veces abreviado como HOTL), la automatización funciona por su cuenta mientras una persona la supervisa e interviene cuando hace falta. Un modelo human-over-the-loop sitúa a las personas en el nivel de gobernanza: fijan objetivos y políticas, revisan el desempeño y deciden cuándo el sistema debe cambiar o detenerse. En un sistema human-out-of-the-loop, la automatización funciona sin intervención humana significativa durante el uso rutinario.
Ninguno de estos es mejor por naturaleza. Una regla de bajo riesgo para clasificar correos no necesita que un empleado apruebe cada clasificación. Un sistema automatizado de rechazo de pagos puede requerir una supervisión más fuerte, porque los falsos positivos bloquean a clientes legítimos. Los vehículos autónomos están en el extremo, donde la supervisión human-on-the-loop es continua. Un sistema usado en diagnóstico por imagen puede exigir que profesionales capacitados interpreten los resultados antes de que afecten la atención al paciente. La pregunta no es si los humanos deben participar siempre. Es dónde deben participar y qué autoridad deben tener.
Por qué importa la validación human-in-the-loop
El argumento más sólido a favor de la revisión humana no es que las personas sean siempre más precisas que las máquinas. No lo son. Los humanos pueden ser inconsistentes, estar cansados, tener sesgos o excederse de confianza. El valor viene de que las personas y los sistemas automatizados fallan de formas distintas. Los modelos de aprendizaje automático procesan grandes volúmenes de manera consistente, pero tropiezan cuando un caso difiere de sus datos de entrenamiento. Los humanos son más lentos y menos consistentes, pero pueden reconocer matices, cuestionar suposiciones y entender por qué una situación inusual requiere una respuesta diferente. Al combinar ambos, el flujo de trabajo se vuelve más resistente: una red de seguridad donde los dos modos de fallo rara vez se superponen.
Detecta resultados plausibles pero erróneos
Los LLM modernos producen explicaciones pulidas que contienen afirmaciones sin respaldo. Los sistemas de imagen generan detalles realistas que nunca existieron. Los modelos predictivos asignan una puntuación precisa incluso cuando la evidencia es débil. Como estos resultados parecen creíbles, atraviesan un flujo de trabajo sin levantar sospechas.
La revisión humana es más valiosa cuando la corrección no puede juzgarse por la sintaxis o el formato. Una respuesta puede ser gramaticalmente perfecta y factualmente falsa. Una recomendación de producto puede coincidir con el historial de un comprador e ignorar una restricción clave. Un resumen de investigación puede sonar perspicaz mientras exagera lo que las respuestas a la encuesta subyacentes realmente respaldan. La IA human-in-the-loop le da a alguien la oportunidad de hacer la pregunta que el sistema no puede hacerse a sí mismo con fiabilidad: ¿esta conclusión tiene sentido en contexto?
Saca a la luz los casos límite
Los sistemas automatizados funcionan mejor cuando los casos nuevos se parecen a los que ya han visto. Los problemas aparecen en los bordes: una solicitud inusual, un nuevo patrón de fraude, un tipo de imagen poco común, una frase ambigua. Estos casos límite importan porque a menudo revelan debilidades en el proceso más amplio.
Supongamos que un sistema de detección de fraude empieza a bloquear transacciones legítimas de clientes que viajan al extranjero. El desempeño general del modelo sigue pareciendo sólido, porque las transacciones afectadas son una fracción pequeña del volumen. Para el cliente, en cambio, el error es una compra rechazada, una confianza dañada y un ticket de soporte. Un revisor que detecte el patrón puede corregir los casos individuales y señalar el problema de fondo, convirtiendo excepciones aisladas en algo sobre lo que el equipo de producto puede actuar.
Hace visible el riesgo
Un sistema totalmente automatizado puede parecer objetivo porque la misma regla se ejecuta cada vez. Pero la consistencia no garantiza la precisión: el sistema puede estar repitiendo el mismo error a gran escala. La supervisión humana crea oportunidades para cuestionar las predicciones del modelo, investigar resultados extraños y detectar sesgos sistemáticos. Cuando los revisores registran por qué cambió un resultado, la organización aprende dónde el sistema es fuerte, dónde es débil y qué decisiones necesitan más control.
El Marco de Gestión de Riesgos de IA del NIST anima a las organizaciones a mapear riesgos, medir el desempeño del sistema, gestionar problemas y establecer una gobernanza adecuada al contexto. Su guía práctica complementaria también insiste en identificar dónde se necesita supervisión humana y en capacitar a las personas responsables de ella.
Respalda el cumplimiento normativo y la rendición de cuentas
Algunos usos regulados de la IA exigen una supervisión humana significativa. El artículo 14 de la Ley de IA de la UE, por ejemplo, exige que los sistemas de IA de alto riesgo se diseñen de modo que las personas puedan supervisarlos de forma efectiva, lo que implica autoridad real para interpretar los resultados e intervenir, no solo un botón de aprobación al final de un flujo de trabajo opaco.
Genera retroalimentación para mejorar
Un resultado corregido puede hacer más que arreglar un error. Cuando las correcciones se estructuran y se registran, retroalimentan el ciclo de vida de la IA. Los equipos de producto detectan categorías de fallo recurrentes. Los científicos de datos mejoran las reglas o reentrenan los modelos de aprendizaje automático. Los equipos de operaciones revisan las guías para revisores. Los líderes ajustan los umbrales de confianza o deciden que ciertas acciones no deberían automatizarse en absoluto. Así es como los ciclos de retroalimentación conectan el desempeño en producción con la mejora del sistema. Sin ese ciclo, los mismos errores se corrigen a mano cientos de veces mientras la causa raíz nunca cambia.
Cómo funciona la validación human-in-the-loop

Un flujo de trabajo human-in-the-loop suele empezar con un resultado automatizado, pero las decisiones de diseño importantes ocurren antes de que ese resultado llegue a un revisor. El equipo decide qué necesita validación, cómo se seleccionan los casos, qué información ve el revisor, qué acciones puede tomar y cómo esas acciones afectan al sistema.
Un proceso típico se ve así:
- Un sistema automatizado produce un resultado o una acción recomendada.
- El sistema asigna una puntuación de confianza, una categoría de riesgo o una regla de validación.
- Los casos seleccionados se derivan a un revisor humano.
- El revisor aprueba, edita, rechaza o escala el resultado.
- La decisión y su justificación quedan registradas.
- Los casos difíciles pasan a un revisor sénior o a un especialista.
- Los resultados validados alimentan producción, informes, control de calidad, entrenamiento o investigación.
- Las correcciones recurrentes se analizan para mejorar el modelo o el proceso.
- Un monitoreo continuo comprueba si la calidad mejora, empeora o cambia.
La secuencia es sencilla; cada paso implica concesiones.
El sistema produce un resultado. Puede ser una clasificación, una recomendación, una puntuación, una imagen, una respuesta, un resumen o una acción completada. A veces es solo una sugerencia; a veces afecta a un cliente a menos que se intercepte. Un modelo que recomienda el asunto de un correo crea una decisión reversible y de bajo costo. Un modelo que rechaza una transacción o prioriza un caso médico afecta a una persona de inmediato, y necesita controles más fuertes incluso con una precisión medida similar.
El resultado se selecciona para revisión. Revisarlo todo da una cobertura sólida, pero suele acabar con las ventajas de velocidad y costo de la automatización. Revisar demasiado poco deja pasar fallos graves. La mayoría de los flujos de trabajo de IA maduros combinan el enrutamiento según riesgo con el muestreo: los resultados por debajo de ciertos umbrales de confianza van a una persona, las categorías de alto riesgo siempre se revisan, y una muestra aleatoria de resultados de “bajo riesgo” se comprueba para detectar deterioros silenciosos del desempeño.
Un revisor evalúa el resultado según criterios claros. El revisor necesita más que el resultado generado: a menudo la solicitud original, el material de origen, la política aplicable, una puntuación de incertidumbre o ejemplos previos. Aquí es donde la explicabilidad se vuelve operativa. Una puntuación de confianza sin contexto crea una falsa seguridad; una predicción sin la evidencia que la respalda obliga al revisor a adivinar. Las buenas interfaces muestran exactamente lo que requiere la tarea de revisión concreta.
El revisor aprueba, corrige, rechaza o escala. Un simple aprobar o rechazar suele ser demasiado tosco. Los revisores pueden necesitar editar una respuesta, cambiar una categoría, señalar un problema de política o pasar el caso a alguien con más experiencia. Escalar no es un fracaso. Es reconocer que la experiencia y la autoridad tienen límites.
La corrección queda registrada. Una decisión es mucho más útil cuando el motivo se captura de forma consistente. Las categorías de error estandarizadas (factualmente incorrecto, incompleto, inseguro, fuera de política, evidencia insuficiente) facilitan el análisis de patrones. Esos registros forman un registro de auditoría que respalda las revisiones de calidad, la gobernanza y el cumplimiento normativo, y revelan si el mismo problema se repite una y otra vez.
Los resultados validados mejoran el sistema. Las correcciones pueden respaldar el aprendizaje supervisado, el aprendizaje activo, cambios en los prompts, revisiones de reglas o mejores instrucciones para los revisores. Sin embargo, no toda corrección debería devolverse directamente a un modelo: los revisores pueden equivocarse, y los ciclos de retroalimentación rápidos pueden consolidar suposiciones erróneas. Las correcciones deben comprobarse en calidad antes de convertirse en datos de entrenamiento. La idea es transformar la retroalimentación humana en evidencia estructurada, no en una limpieza desechable.
Ejemplos de validación human-in-the-loop
La idea se entiende mejor con flujos de trabajo reales, que varían según lo que se valida y lo que ocurre cuando el sistema falla.
Validación de resultados de IA
Una empresa de SaaS lanza un asistente de IA que redacta respuestas a las preguntas de los clientes. En el piloto, el asistente maneja bien las preguntas comunes sobre funciones, pero de vez en cuando inventa capacidades del producto cuando la documentación es escasa, y con tanta seguridad que los clientes podrían no darse cuenta. La primera solución de la empresa es exigir que los agentes aprueben cada borrador. La precisión mejora, pero los tiempos de respuesta apenas cambian, porque los empleados siguen leyendo cada respuesta de principio a fin.
Así que el equipo separa las solicitudes según el riesgo. Las respuestas basadas en documentación aprobada pueden enviarse automáticamente por encima de un umbral de confianza alto. Los reembolsos, las preguntas de seguridad, las reclamaciones contractuales y las respuestas sin fuente requieren la aprobación de un agente. Cada semana se revisa una muestra aleatoria de respuestas automáticas. Lo que cambió no fue simplemente añadir a una persona: fue rediseñar dónde entraba esa persona en el flujo de trabajo, para que la revisión se centrara en la incertidumbre y las consecuencias en lugar del volumen.
Validación del etiquetado de datos
Un minorista quiere entrenar un modelo de visión por computadora para reconocer atributos de producto en las imágenes del catálogo. El primer equipo de anotación etiqueta las prendas por largo de manga, escote, estampado y color, y el primer modelo funciona mal con conjuntos de varias capas y productos parcialmente ocultos. Una auditoría descubre que los etiquetadores interpretaron las reglas de forma distinta: algunos etiquetaron la prenda más visible, otros todas las prendas de la imagen.
Se añade un proceso de segunda revisión para los desacuerdos y los ejemplos inusuales. Las guías incorporan ejemplos positivos, ejemplos negativos y casos límite difíciles, y se mide el acuerdo entre revisores antes de aceptar nuevas etiquetas. La mejora no vino de más etiquetado de datos. Vino de una definición más precisa de la verdad de referencia. Es una lección habitual en el aprendizaje automático human-in-the-loop: un conjunto de datos más grande no es mejor cuando sus etiquetas son inconsistentes.
Validación de respuestas a encuestas

Los sistemas automatizados de encuestas pueden señalar direcciones IP duplicadas, tiempos de finalización imposibles, respuestas repetidas y bots evidentes. Son más débiles cuando una respuesta es inusual pero auténtica. Un encuestado que termina rápido pero escribe respuestas abiertas reflexivas podría ser descartado injustamente por una regla rígida de velocidad, mientras que otro que se demora podría entregar respuestas plausibles pero de poco esfuerzo generadas por una herramienta de IA. Los revisores humanos pueden examinar las entradas sospechosas en contexto, comparando las respuestas abiertas, la consistencia de las respuestas y el comportamiento a lo largo de la encuesta.
Este es el tipo de control de calidad en torno al cual está construido PickFu. Cada respuesta de PickFu proviene de un encuestado humano verificado e incluye una explicación escrita, y los controles de calidad combinan automatización con revisión humana, porque la calidad de las respuestas, y no solo el volumen, decide si los datos merecen confianza. Para los equipos que se preguntan “¿dónde puedo publicar una encuesta?“, la distribución es solo el primer problema. Un montón de respuestas del público equivocado, o de participantes poco fiables, no te dirá nada cierto.
La diferencia se ve en una prueba rápida.
📊 Ejemplo de encuesta: Pedimos a compradores que identificaran al cliente real entre una respuesta genérica con sabor a IA y una respuesta humana específica: una comprobación rápida de si las respuestas de poco esfuerzo o escritas por IA se delatan solas. Ver la prueba.
Moderación de contenido
Los sistemas de moderación de contenido señalan rápidamente posibles casos de acoso, violencia, desnudez o estafas. Los casos claros pueden gestionarse automáticamente; los que dependen del contexto suelen necesitar criterio humano. Una frase que parece amenazante de forma aislada puede ser parte de una noticia o de una conversación sobre seguridad personal. Una publicación de apariencia inofensiva puede volverse abusiva junto a mensajes anteriores. El error es suponer que la moderación humana elimina el sesgo o la inconsistencia. Los revisores necesitan políticas claras, ejemplos, rutas de escalamiento, protección de su bienestar y calibración periódica; de lo contrario, la empresa solo cambia la incertidumbre del modelo por una variación de los revisores que nadie mide.
Detección de fraude
Una plataforma de pagos puntúa las transacciones según señales del dispositivo, el historial, la ubicación y patrones de fraude conocidos. Las reglas agresivas reducen las pérdidas por fraude, pero aumentan los falsos positivos en forma de clientes legítimos rechazados por una compra inusual, un dispositivo nuevo o un viaje al extranjero. Los analistas humanos pueden revisar los casos de alto valor o ambiguos antes de una acción irreversible, y sus decisiones pueden revelar nuevas estrategias de fraude que el modelo pasó por alto. Aquí la limitación es la velocidad: una revisión terminada tres días después no le sirve de nada a un cliente que está en la caja. El diseño del sistema tiene que contemplar tanto la calidad de la decisión como el momento en que se toma.
Revisión médica, legal y financiera
Los entornos profesionales de alto riesgo muestran por qué la automatización y la validación van juntas. En el diagnóstico por imagen, un modelo de visión por computadora puede resaltar una zona que merece atención, pero un clínico la interpreta junto con el historial del paciente, la calidad de la imagen y los síntomas. La FDA, Health Canada y la MHRA del Reino Unido han señalado el desempeño del equipo humano-IA, no del algoritmo por sí solo, como principio rector para los dispositivos médicos basados en aprendizaje automático. Lo mismo ocurre cuando una herramienta de IA resume un contrato o señala actividad financiera inusual: profesionales capacitados siguen validando las conclusiones antes de que afecten derechos legales, créditos o declaraciones. La revisión humana no hace que estos sistemas estén libres de riesgo. Añade una capa de control cuando el costo de una conclusión sin respaldo es demasiado alto para una automatización total.
Validación de producto y marketing
La validación human-in-the-loop también se aplica antes de que una empresa lance un producto, una campaña o un recurso de marca. La IA generativa puede producir decenas de conceptos de empaque, anuncios, nombres, eslóganes, imágenes de producto y pantallas de aplicaciones. Optimiza según patrones visuales o instrucciones, pero no puede predecir con fiabilidad qué entenderá, en qué confiará o qué preferirá un público objetivo concreto.
La retroalimentación de consumidores reales es la forma de comprobarlo. Es el paso human-in-the-loop para decisiones como las pruebas de diseño de empaque, probar el logotipo de una empresa, las pruebas de creatividades generadas por IA, las pruebas de mockups, las pruebas de logotipo y diseño, las pruebas de capturas e iconos para tiendas de aplicaciones, probar eslóganes, probar el nombre de un negocio, hacer una prueba de nombre de marca, la validación de mercado de un prototipo, además de las pruebas A/B en Amazon.
Imagina a una fundadora que usa IA para generar seis direcciones de empaque para un nuevo producto de cuidado de la piel. El equipo interno prefiere el diseño más minimalista porque parece premium. Un sondeo entre consumidores muestra que ese mismo diseño hace difícil entender para qué sirve el producto, mientras que una opción menos llamativa comunica el beneficio con claridad y genera una mayor intención de compra. Eso no demuestra que el empaque ganador vaya a dominar el mercado. Revela un problema de comunicación antes de que la empresa se comprometa con una tirada de producción. La IA amplió el conjunto de opciones; personas reales decidieron cuáles funcionan fuera del equipo que las creó.
Este es el núcleo de donde encaja PickFu. Las personas que compran tu producto, juzgan tu marca y pasan de largo tu anuncio son humanas, así que la lectura final sobre empaques, textos, nombres y diseños también tiene que venir de humanos. La IA puede ampliar las opciones y predecir reacciones, pero una predicción no es una decisión de compra. La retroalimentación cualitativa de personas reales de tu público objetivo es la señal que de verdad refleja cómo se comportará el mercado, y es lo único que un modelo solo puede imitar, nunca reemplazar.
Validación humana frente a validación automatizada
La validación humana y la automatizada resuelven problemas distintos. Los flujos de trabajo más sólidos usan cada una donde tiene ventaja.
La conclusión no es que un humano deba verificar cada resultado. Eso sale caro y empuja a los revisores a aprobar resultados de forma mecánica. Un mejor diseño deja que la automatización se ocupe del trabajo predecible y dirige la atención humana hacia la incertidumbre, el impacto y la novedad.
¿Cuándo conviene usar la validación human-in-the-loop?
La validación humana justifica su costo cuando un error es difícil de detectar automáticamente o costoso de revertir. Una respuesta de IA dirigida a clientes merece más escrutinio que una lluvia de ideas interna. Un modelo que clasifica candidatos a un empleo merece más que uno que ordena archivos internos. Un resumen de investigación sintética merece más cuando se presentará como evidencia de mercado que cuando solo sirve para plantear preguntas de debate.
Considera la revisión humana cuando:
- Los errores pueden perjudicar a usuarios, clientes, pacientes, candidatos o empleados.
- Los resultados influyen en decisiones financieras, legales, médicas, laborales o de seguridad.
- La tarea requiere interpretación, empatía, contexto cultural o conocimiento especializado.
- El sistema maneja datos sensibles o personales.
- El modelo es nuevo, cambió hace poco o trabaja en un entorno desconocido.
- El resultado se publicará o se mostrará directamente a los clientes.
- Las regulaciones, los contratos o las políticas internas exigen supervisión.
- El sistema produce resultados persuasivos que son difíciles de verificar.
- Necesitas datos de referencia (ground truth) fiables.
- Los datos sintéticos o la investigación generada por IA impulsarán una decisión estratégica.
- Los casos inusuales pueden revelar cambios en el comportamiento de los clientes o de los adversarios.
- La acción automatizada es difícil o imposible de revertir.
Pondera las consecuencias junto con la frecuencia. Un fallo que ocurre una vez cada 10 000 casos puede exigir un control estricto si ese único fallo causa un daño grave.
Cuándo la validación human-in-the-loop puede no ser necesaria
La participación humana añade costo, demora y complejidad. No debería incorporarse solo para que un flujo de trabajo suene responsable. Las tareas repetitivas y de bajo riesgo suelen resolverse mejor con reglas automatizadas y comprobaciones puntuales periódicas: la validación de formatos de archivo, la detección de duplicados, la comprobación de campos obligatorios y los cálculos deterministas rara vez necesitan que una persona apruebe cada resultado.
La revisión humana aporta poco cuando la tarea es de bajo riesgo y fácil de revertir, cuando la corrección sigue reglas claras, cuando los errores ocasionales son aceptables y se detectan rápido, cuando el resultado es un borrador interno que de todos modos se revisará después, cuando las pruebas automatizadas ya ofrecen una cobertura sólida, cuando los revisores no tienen acceso a contexto adicional, cuando la demora causaría más daño que los errores probables, o cuando es probable que la persona apruebe los resultados sin evaluarlos de verdad. Un equipo que genera ideas de titulares internos no necesita un comité que inspeccione cada línea. La verdadera pregunta es si un paso de revisión definido mejora el resultado lo suficiente como para justificar la carga que añade.
Beneficios de la validación human-in-the-loop
Los beneficios son reales, pero dependen de cómo se diseñe el flujo de trabajo.
Mayor precisión donde el contexto importa. Un revisor puede contrastar un resultado con hechos, políticas y un contexto situacional que el modelo nunca recibió. Eso es especialmente útil con los modelos de lenguaje de gran tamaño, donde un texto fluido puede ocultar errores factuales o lógicos.
Un despliegue de IA más seguro. La revisión humana puede detener resultados inciertos o de alto impacto antes de que lleguen a los usuarios, y puede exponer modos de fallo durante un piloto limitado, cuando los equipos rara vez conocen de antemano todos los modos de fallo.
Mejor manejo de los matices. Las preferencias de los consumidores, el humor, las referencias culturales y el tono de marca no se reducen limpiamente a reglas. La retroalimentación humana ayuda a interpretar por qué funciona una opción, no solo si superó una comprobación técnica. La IA puede generar imágenes de producto, por ejemplo, con un acabado técnico impecable que los compradores igual perciben como poco realistas o impropias de la marca para ese precio. Una prueba de preferencia saca a la luz reacciones que las métricas de calidad de imagen no pueden captar.
Mejores datos de entrenamiento y evaluación. Los ejemplos revisados por humanos pueden convertirse en etiquetas, referencias o conjuntos de evaluación para el aprendizaje supervisado, siempre que la calidad de la anotación se mantenga. Los revisores mal capacitados crean etiquetas inconsistentes que perjudican el desempeño del modelo, así que el control de calidad también tiene que cubrir a los humanos.
Mejora continua. Los ciclos de retroalimentación bien diseñados muestran a los equipos dónde sigue fallando la automatización, para que puedan cambiar prompts, umbrales, datos de entrenamiento o reglas basándose en evidencia. Con el tiempo, los casos comunes necesitan menos intervención, mientras que los nuevos o de alto riesgo siguen recibiendo atención.
Más confianza y rendición de cuentas. Las personas están más dispuestas a usar un sistema de IA cuando entienden sus límites y saben que existe una vía de escalamiento real. La confianza no nace de un vago “hay un humano involucrado”. Nace de explicar qué hace el sistema, qué decisiones se revisan, cómo se pueden impugnar los errores y quién es responsable.
Limitaciones y riesgos
La revisión humana no es automáticamente precisa, neutral ni escalable. Una supervisión mal diseñada añade costo sin reducir el riesgo.
Sesgo del revisor. Los revisores traen sus propias suposiciones e incentivos, y un humano puede corregir un tipo de sesgo del modelo mientras introduce otro. Los equipos diversos, los criterios claros, el análisis de desacuerdos y las auditorías periódicas lo reducen, pero ningún proceso elimina el juicio por completo.
Decisiones inconsistentes. Dos personas expertas pueden leer el mismo resultado de forma distinta, sobre todo en cuestiones de tono, seguridad y preferencia creativa. Mide el acuerdo entre revisores en lugar de dar por hecho el consenso; un acuerdo bajo suele indicar una capacitación débil, instrucciones poco claras o una tarea ambigua de verdad.
Fatiga del revisor. La revisión de grandes volúmenes se vuelve repetitiva, y la gente empieza a ceder ante el modelo o a aprobar resultados porque corregirlos da más trabajo. Eso es el sesgo de automatización: tratar al modelo como correcto por defecto. Ayudan las colas más cortas, la rotación, mejores interfaces y priorizar las decisiones de alto valor. Pedir a personas que revisen miles de resultados casi idénticos y de bajo riesgo rara vez es un buen uso de la inteligencia humana.
Lentitud y costo elevado. La revisión puede convertirse en un cuello de botella, con colas que crecen y respuestas que se retrasan. El muestreo según riesgo es la solución: concentra la revisión donde cambia los resultados.
Privacidad y seguridad. Los revisores pueden ver información personal, médica, financiera o confidencial. Limita el acceso a lo necesario, anonimiza cuando sea posible, registra las acciones de los revisores y examina con cuidado a los proveedores externos de anotación, ya que los datos sensibles pueden salir de tu control.
Exceso de confianza en el juicio humano. Añadir a una persona puede crear una falsa tranquilidad. Un revisor sin la experiencia adecuada puede no estar mejor situado que el modelo para detectar un error. Un sello de aprobación humana no es prueba de verdad; los equipos siguen necesitando conjuntos de evaluación, análisis de errores y monitoreo de resultados.
Ciclos de retroalimentación que refuerzan errores. Las correcciones humanas suelen tratarse como verdad de referencia, pero los revisores pueden compartir las mismas suposiciones erróneas. Alimentar un modelo con cada corrección puede institucionalizarlas. Comprueba la consistencia y la representatividad de la retroalimentación humana antes de convertirla en datos de entrenamiento.
Buenas prácticas para la validación human-in-the-loop

Un flujo de trabajo HITL fiable empieza con claridad operativa. Los revisores necesitan saber qué están validando, qué se considera aceptable y qué hacer cuando tienen dudas.
Define criterios de validación claros. “Asegúrate de que la respuesta sea buena” no sirve. Nombra las dimensiones: una respuesta de IA puede revisarse por precisión factual, relevancia, completitud, seguridad, tono, respaldo de fuentes y política. Un concepto de empaque puede juzgarse por claridad, credibilidad, distintividad e intención de compra. Los criterios deben reflejar el resultado buscado: un diseño atractivo sigue fallando si los clientes malinterpretan para qué sirve el producto.
Capacita a los revisores con ejemplos realistas. Incluye aciertos evidentes, fallos evidentes y casos ambiguos, y muestra por qué se tomó una decisión, no solo qué botón se pulsó. Los ejercicios de calibración, en los que varios revisores puntúan los mismos casos y discuten los desacuerdos, son especialmente útiles.
Mide el acuerdo entre revisores. El acuerdo entre evaluadores muestra con qué consistencia aplican los criterios. Un acuerdo bajo no siempre es un mal desempeño: puede significar que la tarea es subjetiva o que la información es insuficiente, lo cual es una perspectiva útil sobre el producto. Responde aclarando definiciones, añadiendo ejemplos o escalando ciertas categorías.
Usa reglas de escalamiento. Los revisores deben saber cuándo no decidir: excepciones de política, riesgo legal, seguridad personal, contenido desconocido o desacuerdo entre expertos. Las rutas de escalamiento protegen tanto al usuario como al revisor.
Muestrea con estrategia. Revisa todos los casos de alto impacto o alta incertidumbre, y toma muestras aleatorias de los resultados de menor riesgo para detectar problemas ocultos. El muestreo debe cambiar con el tiempo: revisión amplia en el lanzamiento, revisión rutinaria más ligera cuando el desempeño se estabilice.
Monitorea la calidad a lo largo del tiempo. Un estudio de validación puntual no garantiza el desempeño futuro. El comportamiento de los clientes cambia, el fraude evoluciona, las políticas se actualizan y los modelos derivan. Haz seguimiento de las tasas de error, el acuerdo, los patrones de escalamiento y los resultados entre versiones del modelo a lo largo de todo el ciclo de vida de la IA.
Crea registros de auditoría útiles. Registra la entrada, el resultado, la versión del modelo, la puntuación de confianza, la decisión del revisor, la corrección, la justificación y la marca de tiempo. Un buen registro responde preguntas posteriores: ¿por qué se aprobó esto? ¿Qué versión lo produjo? ¿Tenía el revisor la información correcta? ¿Este error se repite? Los registros deben diseñarse para investigar, no acumularse porque sí.
Protege los datos sensibles. Da a los revisores solo lo que la tarea requiere. Enmascara los identificadores personales, mantén el acceso basado en roles y monitoreado, y fija políticas de retención claras para que la revisión no cree un archivo indefinido de datos sensibles.
Validación human-in-the-loop para sistemas de IA
La IA human-in-the-loop es especialmente útil porque los resultados de la IA son probabilísticos, persuasivos y difíciles de verificar. El software tradicional sigue reglas explícitas: mismas entradas, mismo resultado. La IA generativa y muchos modelos de aprendizaje automático infieren patrones a partir de datos y producen resultados por probabilidad. Esa flexibilidad permite que los LLM y otros sistemas manejen tareas complejas, pero también dificulta las pruebas exhaustivas basadas en reglas.
Una capa human-in-the-loop puede respaldar los flujos de trabajo de IA revisando las predicciones del modelo, comprobando el texto y las imágenes generados, detectando alucinaciones, evaluando la seguridad y el cumplimiento de políticas, construyendo y validando conjuntos de datos de referencia, monitoreando la deriva del modelo, corrigiendo errores de anotación de datos y aprobando acciones con consecuencias. El diseño debe ajustarse al sistema: una herramienta de procesamiento del lenguaje natural puede necesitar revisión factual y contextual, un modelo de visión por computadora puede necesitar especialistas en imagen para las clasificaciones dudosas, y cuanta más autoridad tenga un sistema, más importa definir los puntos de intervención.
Validación human-in-the-loop y agentes de IA
Los agentes de IA ejecutan múltiples acciones hacia un objetivo en lugar de producir un único resultado aislado. Consultan bases de datos, llaman a herramientas, actualizan registros, contactan a clientes e inician transacciones, lo que multiplica el riesgo, porque una suposición equivocada puede condicionar varias acciones posteriores. Los controles para agentes de IA pueden incluir aprobación antes de llamadas a herramientas con consecuencias, límites de gasto, permisos restringidos, puntos de control tras decisiones importantes y escalamiento automático cuando la incertidumbre aumenta. Un agente de planificación de viajes podría comparar vuelos y preparar un itinerario por su cuenta, y luego exigir aprobación explícita antes de comprar un boleto no reembolsable. Velocidad durante la investigación, control humano sobre el paso irreversible. La supervisión debe integrarse en los permisos del agente, no añadirse después del despliegue.
Umbrales de confianza y revisión selectiva
No todos los resultados necesitan la misma intervención. Un sistema puede derivar a personas las predicciones de baja confianza mientras acepta automáticamente las de alta confianza, pero la confianza tiene que validarse contra resultados reales, porque un modelo puede equivocarse con total seguridad. Calibra los umbrales con datos históricos y revísalos por grupos de clientes; un único umbral global puede ocultar un desempeño débil en casos poco frecuentes. El muestreo aleatorio de resultados de alta confianza sigue importando, porque comprueba si la confianza del modelo sigue coincidiendo con la precisión real.
Aprendizaje activo
El aprendizaje activo es un enfoque de aprendizaje automático en el que el sistema señala los ejemplos que resultarían más informativos para que una persona los etiquete: casos en los que tiene dudas, en los que los modelos discrepan o en los que los datos son escasos. Hace más eficiente la anotación de datos al concentrar el esfuerzo humano donde las nuevas etiquetas ayudan más. La contrapartida: los ejemplos dudosos suelen ser inusualmente difíciles, así que los revisores necesitan una guía sólida, y los datos resultantes no deben darse por correctos solo porque los aportó un humano.
Aprendizaje automático human-in-the-loop
En el aprendizaje automático human-in-the-loop, las personas contribuyen en la recopilación de datos, el entrenamiento, la evaluación, el despliegue y el monitoreo. Definen las categorías de etiquetas, anotan ejemplos, resuelven desacuerdos, revisan errores del modelo, validan predicciones, investigan cambios en el desempeño, señalan resultados dañinos y deciden si un modelo está listo para un uso más amplio. La aportación humana pasa a formar parte de cómo aprende el sistema, no es un único paso de aprobación.
Retroalimentación humana y RLHF
El aprendizaje por refuerzo a partir de retroalimentación humana, o RLHF, es un método para usar las preferencias humanas con el fin de moldear el comportamiento de un modelo. En una versión simplificada, las personas comparan o clasifican los resultados del modelo, y esas preferencias entrenan un modelo de recompensa que guía el entrenamiento posterior, un enfoque que OpenAI ha descrito para entrenar modelos que siguen instrucciones. El RLHF está relacionado con el trabajo human-in-the-loop, pero no es lo mismo. La validación HITL puede ocurrir en producción, control de calidad, investigación o aprobación; el RLHF es un método de entrenamiento. Puedes hacer validación HITL sin RLHF, y puedes usar RLHF para entrenar un modelo que igual necesite validación humana tras el despliegue.
Investigación de producto human-in-the-loop para la IA
La investigación de producto human-in-the-loop para la IA aplica el mismo principio a las decisiones de producto y marketing: la IA ayuda a los equipos a generar y organizar opciones, y consumidores reales validan cómo se reciben esas opciones.
Esto importa sobre todo para las empresas en etapa temprana, porque las herramientas generativas han hundido el costo de crear conceptos. Un fundador puede producir diez direcciones de logotipo, cinco maquetas de página de aterrizaje o veinte variaciones de anuncio en una tarde. El cuello de botella pasó de la producción a la selección, y los equipos internos son malos jueces de esa selección, porque saben demasiado sobre el producto. Completan mentalmente los mensajes poco claros, captan referencias sutiles de marca y pasan por alto objeciones que resultan obvias para un cliente que llega por primera vez. La retroalimentación humana devuelve la perspectiva externa. Es una de las alternativas a los focus groups más prácticas al alcance de un equipo pequeño: más rápida y barata que reunir a un grupo de personas en una sala, y dirigida a tu público objetivo real.
De las pruebas de creatividades generadas por IA a la evidencia de mercado

En las pruebas de creatividades generadas por IA, un equipo usa IA para generar varias direcciones y luego pregunta a consumidores objetivo qué versión es la más clara, la más confiable o la que más probablemente se gane un clic. Define la pregunta de investigación antes de lanzar: preguntar qué diseño le “gusta” a la gente produce un ganador sin decirte si cumple el objetivo de negocio. Las preguntas más sólidas suenan así: ¿qué anuncio comunica el beneficio con mayor claridad? ¿Qué empaque parece creíble al precio previsto? ¿Qué icono de aplicación se lee bien en tamaño pequeño? ¿Qué eslogan encaja con el posicionamiento? La retroalimentación valida un criterio de decisión, no el gusto del diseñador.
Así se ve con datos reales. Generamos dos conceptos de anuncio para una crema hidratante ficticia, uno un render pulido del producto y otro una foto de estilo de vida centrada en el problema, y los probamos con compradores con piel seca.
📊 Ejemplo de encuesta: Dos anuncios de crema hidratante generados por IA, probados con 15 compradores de EE. UU. con piel seca. Ver cómo se compararon.
Lo que mostraron los resultados:
- El render pulido del producto ganó, 60 % frente a 40 %, sobre la versión de estilo de vida.
- “Hidratación que dura todo el día” fue el motivo para hacer clic más repetido: un beneficio concreto le ganó a una atmósfera.
- El 40 % que eligió el anuncio de estilo de vida quería ver “personas reales” y resultados reales en la piel, así que el concepto perdedor seguía aportando una señal que vale la pena probar después.
Una división tan ajustada es justo lo importante. La IA produjo ambas opciones en minutos; personas reales revelaron que una promesa de beneficio clara le ganó a una escena atractiva, y que un segmento sigue queriendo un rostro humano. Ninguna de las dos conclusiones estaba disponible desde dentro del equipo.
Un minicaso: probar el logotipo de una empresa
Una empresa de software B2B usa un modelo de imagen para crear varios conceptos de logotipo. Los fundadores prefieren un símbolo detallado que pretende representar conectividad, analítica y automatización. Durante las pruebas de logotipo y diseño, los clientes potenciales describen una y otra vez la marca como un logotipo del sector salud. La alternativa más sencilla significa menos para los fundadores, pero el mercado la lee con más precisión, así que la empresa cambia de rumbo antes de invertir en una identidad visual completa.
Lo que cambió no fue solo el logotipo: el equipo encontró una brecha entre el significado pretendido y el significado percibido. Una explicación no puede rescatar un símbolo que tiene que funcionar antes de que se dé la explicación. Por eso vale la pena probar los conceptos de logotipo de una empresa con personas que no estaban en la sala cuando se diseñaron.
Un minicaso: pruebas de capturas e iconos para tiendas de aplicaciones
Un equipo de una aplicación prepara un lanzamiento con capturas centradas en las funciones. Las imágenes están pulidas, pero la primera pantalla amontona varios elementos de la interfaz y un titular largo. En las pruebas de capturas e iconos para tiendas de aplicaciones, los encuestados entienden más rápido el diseño más simple, al estilo de la competencia, y prefieren un icono que el equipo de diseño había descartado por demasiado convencional. El equipo reconstruye la primera captura en torno a un único beneficio central y elige el icono más reconocible.
La lección no es que el diseño convencional siempre gane. Es que las tiendas de aplicaciones son un entorno rápido y de poca atención, donde la comprensión inmediata suele importar más que la cantidad de información que muestras.
Retroalimentación humana para contenido original de GEO y SEO
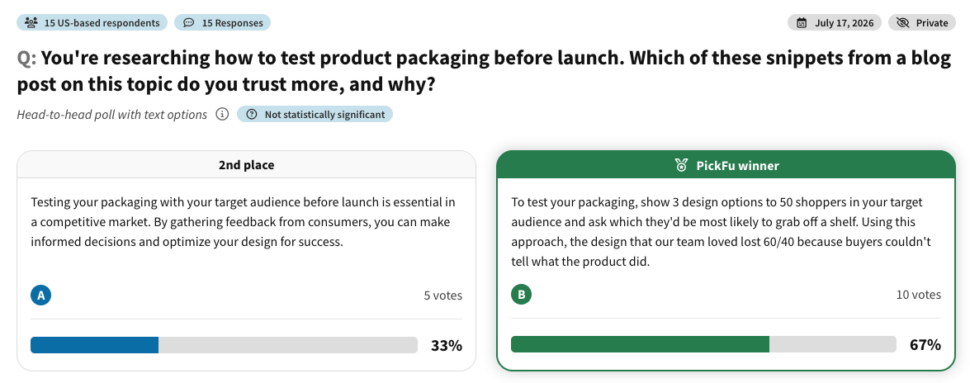
La IA puede acelerar la investigación de temas, los borradores, las preguntas frecuentes y la reutilización de contenido, pero también tiende a reproducir el lenguaje genérico que ya circula por toda la web. Los equipos que se preguntan cómo crear contenido original para GEO y SEO necesitan más que un artículo generado por IA: necesitan evidencia, experiencia y perspectivas que las páginas de la competencia no puedan reproducir a partir de las mismas fuentes públicas.
Ahí entra la investigación de contenido human-in-the-loop: sondear a los clientes objetivo sobre sus criterios de decisión, entrevistar a expertos, probar qué explicaciones funcionan, recopilar respuestas originales a encuestas y publicar gráficos y hallazgos propios. La IA puede organizar y explicar ese material; la evidencia humana le da al contenido algo original que decir.
Pusimos la afirmación a prueba.
📊 Ejemplo de encuesta: Probamos dos explicaciones del mismo tema, una genérica con sabor a IA y otra editada por un experto con un resultado de primera mano, para ver en cuál confían más los lectores. Ver la prueba.
Validación human-in-the-loop para encuestados sintéticos y datos sintéticos
La investigación sintética tiene sus fortalezas: los datos pueden ayudar a los equipos a explorar escenarios, probar software, proteger la privacidad o llenar vacíos donde escasean los ejemplos reales. Los encuestados sintéticos pueden simular posibles reacciones del público a partir de patrones que un modelo de IA ha aprendido.
El riesgo aparece cuando la simulación se confunde con la observación. Una persona sintética puede generar una objeción plausible a un producto, lo que quizá te ayude a preparar mejores preguntas de investigación, pero no establece con qué frecuencia los clientes reales tienen esa objeción, ni cuánto influye en lo que compran.
La validación humana mejora la investigación sintética al comparar las respuestas sintéticas con datos conocidos de clientes, detectar personas estereotipadas o demasiado simplificadas, comprobar si las afirmaciones tienen respaldo y separar la lluvia de ideas de la evidencia. Este es el corazón de encuestados sintéticos frente a retroalimentación de consumidores reales, y no debería plantearse como una competencia en la que uno reemplaza al otro.
Los resultados sintéticos son rápidos, baratos y de verdad útiles para algunas tareas: segmentación amplia, lecturas direccionales de alto nivel y generación de hipótesis que vale la pena probar. Se vuelven más inestables justo donde una decisión se vuelve específica: la preferencia creativa matizada (pedirle a alguien que compare tres diseños y explique por qué gana uno), las reacciones cualitativas detalladas y las predicciones a futuro sobre cómo responderá realmente un público concreto.
La precisión tampoco es estable: el mismo método sintético puede seguir de cerca los resultados humanos en una tarea y fallar estrepitosamente en la siguiente. Por eso una respuesta sintética se trata mejor como hipótesis, no como evidencia, hasta que personas reales la confirmen.
Supongamos que un equipo evalúa una nueva suscripción de kits de comida. Le preguntan a un LLM, actuando como persona sintética de su comprador objetivo, qué impediría que alguien se suscribiera: una forma rápida de generar una hipótesis. La respuesta suele empezar por el precio. Es un punto de partida razonable, pero las personas sintéticas tienden a sobrevalorar el precio y a restar peso a fricciones más discretas como “¿esto encajará de verdad en mi rutina?”.

La forma de averiguarlo es plantear la misma pregunta a personas reales de tu público objetivo: el paso de validación para el que está hecho PickFu. Aquí está ese planteamiento como sondeo real:
📊 Ejemplo de encuesta: La misma pregunta sobre kits de comida (¿qué es lo que más te frenaría a la hora de suscribirte?) planteada a consumidores reales en lugar de a una persona sintética. Lánzala en PickFu y luego compara las respuestas reales con la suposición sintética. Ver la prueba.
Para dejar claro el límite: la validación humana puede hacer que los resultados sintéticos sean más realistas y señalar conclusiones sin respaldo, pero no puede convertir opiniones simuladas en evidencia de que personas reales las sostienen. Las encuestas de PickFu llegan a encuestados humanos verificados, personas reales de tu público objetivo y no generadas por IA, así que son la forma de contrastar una hipótesis sintética con reacciones reales, no otra simulación encima de la primera.
Y a medida que la IA llena cada canal con más variaciones que clasificar, ese tipo de validación humana real importa más, no menos: el público de todo ese contenido generado por IA sigue siendo humano.
Cómo construir un flujo de trabajo de validación human-in-the-loop
Un flujo de trabajo útil empieza por la decisión, no por la tecnología. Define primero qué intentas proteger o mejorar (precisión factual, seguridad del cliente, claridad creativa, reducción del fraude, calidad de la investigación, cumplimiento de políticas o mejores datos de entrenamiento) y luego diseña el nivel adecuado de participación humana.
- Define qué necesita validación. “Revisar el contenido de IA” es demasiado amplio. “Verificar que las respuestas dirigidas a clientes estén respaldadas por la documentación de producto aprobada” es utilizable.
- Clasifica los resultados por riesgo. Pondera el impacto de un error, si es reversible, a quién afecta y con qué facilidad se detecta. Un modelo de bajo/medio/alto funciona si los niveles reflejan tu contexto de negocio real.
- Decide qué resultados necesitan revisión humana. Los de alto riesgo pueden necesitar revisión completa; los de riesgo medio pueden derivarse según la confianza o ciertos desencadenantes; los de bajo riesgo pueden ejecutarse automáticamente con muestreo periódico.
- Crea guías de validación. Documenta qué examinar, qué evidencia usar y qué cuenta como aprobar, corregir, rechazar o escalar, con ejemplos tomados de condiciones reales.
- Capacita y calibra a los revisores. Haz que varios evalúen los mismos casos piloto y luego comparen y discutan. Esto expone los criterios poco claros antes de que lleguen a producción.
- Ejecuta un piloto controlado. Empieza con un volumen o unas acciones limitados. Mide dónde falla el sistema, con qué frecuencia intervienen los revisores y si el flujo de trabajo genera demoras inaceptables.
- Mide el acuerdo y los resultados. Las tasas de aprobación altas por sí solas no demuestran el éxito: los revisores pueden estar aprobando con demasiada facilidad, o recibiendo casos que nunca necesitaron atención.
- Añade rutas de escalamiento. Especifica qué casos necesitan especialistas o revisión legal, y no penalices a los revisores por escalar una duda genuina.
- Registra las decisiones y las correcciones. Captura motivos estructurados para que afloren los patrones recurrentes, con contexto suficiente para reconstruir lo que pasó.
- Mejora el modelo, las reglas o el proceso. Usa los hallazgos validados para corregir las causas raíz: prompts, datos de origen, umbrales, políticas, reentrenamiento o la experiencia del cliente.
- Reevalúa con regularidad. Revisa el diseño tras cambios de modelo, nuevos casos de uso, actualizaciones de políticas, cambios de audiencia o patrones de fallo emergentes.
Métricas de la validación human-in-the-loop
Las métricas deben mostrar si la participación humana mejora las decisiones, no solo si los revisores están ocupados. Entre las medidas útiles están la precisión y la tasa de error, la tasa de falsos positivos y falsos negativos, el acuerdo entre revisores, la tasa de corrección y de escalamiento, la tasa de reversión tras una revisión sénior, el tiempo de respuesta de la revisión, el costo por elemento revisado, el porcentaje de resultados de alto riesgo revisados, la deriva de la calidad con el tiempo y la mejora del modelo tras la retroalimentación.
La combinación adecuada depende del flujo de trabajo. Un sistema antifraude puede priorizar las tasas de falsos positivos y falsos negativos, porque importan tanto la fricción para el cliente como las pérdidas por fraude. Un flujo de contenido puede poner el acento en la tasa de correcciones factuales y el tiempo de publicación. Una prueba creativa puede centrarse en la comprensión, la preferencia y la intención de compra por segmentos.
Lee las métricas en conjunto, además: una tasa de corrección a la baja podría significar que el modelo mejoró, o que los revisores dejaron de prestar atención. La propia medición necesita interpretación, que es un lugar más donde el juicio humano sigue siendo necesario.
Errores comunes en la validación human-in-the-loop
El error más común es suponer que cualquier participación humana crea una supervisión fiable. Una persona sin tiempo, experiencia, contexto o autoridad es poco más que un aprobador ceremonial. Otros errores frecuentes:
- Instrucciones vagas, o revisar cada resultado sin importar el riesgo
- Revisar demasiado pocos resultados para detectar problemas sistemáticos
- Tratar todas las predicciones como si tuvieran las mismas consecuencias
- Omitir la medición del acuerdo entre revisores, o ignorar la fatiga y el sesgo de automatización
- Tratar el juicio de un solo revisor como verdad de referencia incuestionable
- Recopilar correcciones sin devolverlas al proceso
- Cambiar de modelo sin actualizar los criterios de revisión
- Exponer a los revisores a datos sensibles innecesarios
- Usar validación sintética sin referencias del mundo real
- Presentar un resultado como “validado por humanos” sin explicar el método
Supongamos que un equipo de marketing usa un LLM para redactar 100 anuncios para redes sociales y le pide a un empleado que los apruebe en una tarde. Técnicamente el flujo de trabajo incluye supervisión humana, pero el volumen obliga a un repaso apresurado, el revisor carece de datos sobre el cliente objetivo y no se registra ningún motivo.
Un proceso más sólido elimina automáticamente los duplicados y las infracciones de política, hace que el equipo preseleccione conceptos estratégicamente distintos y los prueba con consumidores objetivo. El esfuerzo humano se dedica primero a la curación experta y luego a la validación de mercado. Menos revisión, mejor evidencia.
Lista de verificación para la validación human-in-the-loop
Úsala al evaluar un flujo de trabajo nuevo o existente:
- ¿El objetivo de validación está claramente definido y vinculado a una decisión de negocio concreta?
- ¿Los resultados están categorizados por riesgo y consecuencias?
- ¿Está claro qué casos requieren revisión humana, y los umbrales de confianza se han contrastado con resultados reales?
- ¿Las guías para revisores están documentadas, con ejemplos difíciles y ambiguos?
- ¿Los revisores están capacitados, calibrados y cuentan con suficiente contexto para decidir?
- ¿Se mide el acuerdo entre revisores?
- ¿Los revisores pueden editar, rechazar y escalar, y los casos de alto riesgo se derivan a especialistas?
- ¿Se registran las decisiones y las correcciones, y se protegen los datos sensibles?
- ¿Se auditan muestras aleatorias de las aprobaciones automáticas?
- ¿Los errores recurrentes se usan para mejorar el modelo o el proceso?
- ¿Se monitorea la calidad entre versiones del modelo y grupos de clientes?
- ¿Se miden la fatiga y la carga de trabajo de los revisores?
- ¿Se comunican las limitaciones del proceso, y hay alguien claramente responsable del resultado?
El verdadero propósito de la validación human-in-the-loop
La validación human-in-the-loop suele presentarse como un método técnico para mejorar la precisión de la IA. Para los líderes de negocio, se entiende mejor como una forma de asignar el juicio. La automatización debe encargarse del trabajo que se beneficia de la velocidad, la consistencia y la escala. Las personas deben participar donde el contexto, la responsabilidad, la incertidumbre o las consecuencias hacen que su juicio valga lo que cuesta.
Ese principio se mantiene tanto si revisas una respuesta a un cliente generada por IA, como si comparas opciones de diseño o decides si una investigación sintética refleja el comportamiento real de los consumidores. El objetivo no es un humano detrás de cada máquina. Es evitar que la eficiencia se convierta en excusa para evidencia débil, riesgos invisibles o decisiones que nadie puede explicar.
Si tu próxima decisión involucra creatividades, empaques, nombres o conceptos de producto generados por IA, el paso human-in-the-loop es una prueba rápida con personas reales antes de comprometer el presupuesto.
Crea una cuenta gratuita de PickFu para lanzar tu primera encuesta y empezar a recopilar opiniones humanas reales que respalden tus decisiones de negocio.
Preguntas frecuentes
¿Cuál es el proceso de verificación human-in-the-loop?
Empieza cuando un sistema automatizado produce un resultado, una predicción o una acción recomendada. El sistema deriva los casos seleccionados a una persona según el riesgo, la incertidumbre, las reglas de muestreo o los umbrales de confianza. El revisor contrasta el resultado con criterios definidos y luego lo aprueba, corrige, rechaza o escala. La decisión se registra en un registro de auditoría y puede usarse para mejorar el desempeño futuro del modelo, las políticas, los datos de entrenamiento o los flujos de trabajo de IA.
¿En qué ayuda la evaluación human-in-the-loop?
Ayuda a los equipos a encontrar errores factuales, resultados ambiguos, recomendaciones inseguras, sesgos, alucinaciones y casos límite que la evaluación automatizada pasa por alto. También revela por qué falló un modelo, para que el equipo pueda mejorar sus datos, prompts, reglas, interfaz o modelos de aprendizaje automático en lugar de corregir el mismo error de producción una y otra vez.
¿Qué es la IA human-in-the-loop?
Es un enfoque en el que las personas participan en el desarrollo, la evaluación, la operación o la supervisión de un sistema de IA: etiquetando datos, validando predicciones, aprobando acciones, resolviendo casos dudosos, dando retroalimentación o decidiendo cuándo el sistema debe cambiar o detenerse. El nivel de participación depende de la complejidad y el riesgo de la tarea.
¿Cuáles son los beneficios de la IA human-in-the-loop?
Mayor precisión contextual, mejor manejo de los casos inusuales, un despliegue más seguro, mejores datos de entrenamiento, mayor rendición de cuentas y ciclos de retroalimentación más útiles. Todo esto depende de la experiencia de los revisores, de guías claras, de un muestreo adecuado y del monitoreo de la calidad: la revisión humana no es fiable por sí sola solo porque haya una persona involucrada.
¿Cómo se aplica el human in the loop a los agentes de IA?
Los controles human-in-the-loop pueden exigir aprobación antes de que un agente ejecute acciones con consecuencias: enviar mensajes externos, modificar registros de clientes, hacer compras, mover dinero o borrar datos. Las acciones de menor trascendencia pueden seguir automatizadas, de modo que el agente investiga y prepara una recomendación mientras una persona conserva la autoridad sobre los pasos irreversibles o de alto riesgo.
¿Cuáles son algunos ejemplos de validación human-in-the-loop en IA?
Empleados que comprueban respuestas a clientes generadas por IA, analistas que revisan sospechas de fraude, moderadores que evalúan contenido ambiguo, clínicos que interpretan resultados de diagnóstico por imagen, investigadores que validan respuestas sintéticas a encuestas y consumidores que evalúan anuncios o mockups de producto generados por IA. El papel humano puede ser aprobar, corregir, rechazar, explicar o escalar.
¿Cuál es la diferencia entre human-in-the-loop y human-on-the-loop?
Human-in-the-loop suele significar que una persona participa directamente en una decisión, como aprobar un resultado antes de usarlo. Human-on-the-loop significa que el sistema funciona por su cuenta mientras una persona lo supervisa e interviene cuando hace falta. Cuál encaja depende de la velocidad, la autonomía y el riesgo del sistema.
¿Puede la validación human-in-the-loop eliminar el sesgo de la IA?
Puede ayudar a identificarlo y reducirlo, pero no puede garantizar su eliminación. Los revisores pueden introducir sus propios sesgos, y los equipos pueden compartir suposiciones ya presentes en el modelo o en los datos. Los criterios claros, la evaluación diversa, el análisis de resultados y las auditorías independientes siguen siendo necesarios.
¿Cómo se mide la calidad de la validación humana?
Mediante el acuerdo entre revisores, las tasas de corrección y de error, las tasas de escalamiento, las reversiones en revisión sénior, los hallazgos de auditoría, el tiempo de respuesta y la comparación con una verdad de referencia revisada por expertos. La medida más importante es si la participación humana mejora el resultado real que el sistema fue construido para respaldar.