2026-07-29
Валидация с участием человека: что это, как работает и когда применять
Коротко: валидация с участием человека сочетает автоматизированные системы с профессиональным человеческим суждением. Люди проверяют, исправляют, утверждают или эскалируют результаты работы машин там, где точность, контекст, этика или риск важнее всего. …
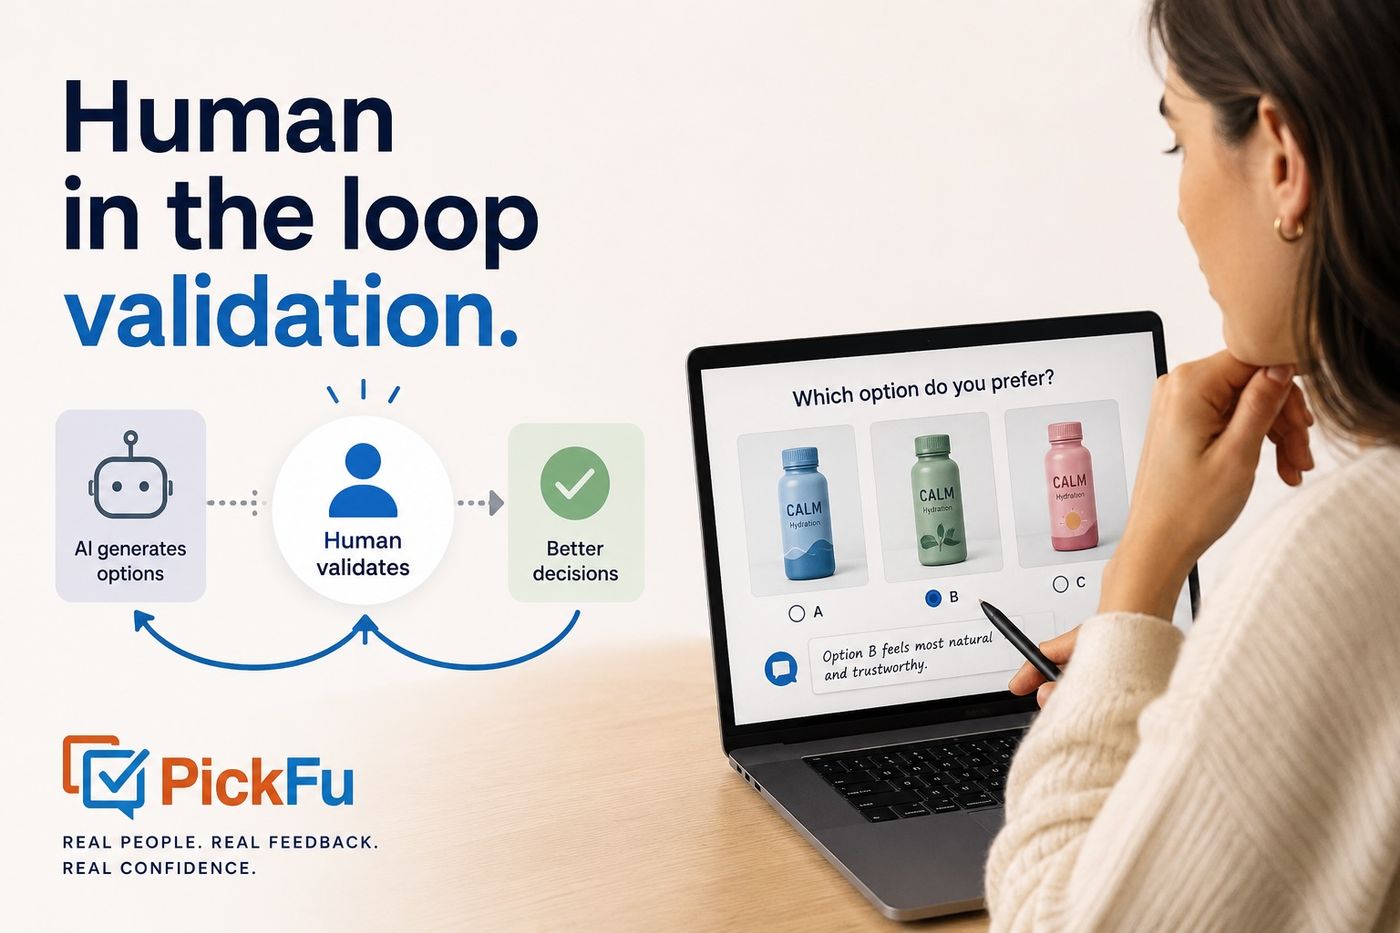
Коротко: Валидация с участием человека (human-in-the-loop) сочетает автоматизированные системы с суждением подготовленных людей. Люди проверяют, исправляют, утверждают или эскалируют результаты работы машины в тех точках, где особенно важны точность, контекст, этика или риск. Такой подход применяют в ИИ, машинном обучении, разметке данных, модерации контента и потребительских исследованиях, чтобы ловить ошибки, которые пропускает автоматика, — а при грамотной организации ещё и возвращать эти исправления в систему, чтобы она становилась лучше. Для команд, принимающих решения о продукте, дизайне и маркетинге, «человеческий шаг» обычно означает получение обратной связи от реальных людей из целевой аудитории — именно для этого и создан PickFu.
Автоматизация быстро обрабатывает огромные объёмы данных, но буксует, когда случай необычный, чувствительный или с высокой ценой ошибки. Проверка человеком — это осознанный шаг, на котором решается, достаточно ли хорош результат, чтобы на него опираться. В этом руководстве мы разбираем, что такое валидация с участием человека, как она работает, где помогает, где нет и как она применяется к повседневным продуктовым и маркетинговым решениям, а не только к техническим ИИ-системам.
Валидация с участием человека, которую часто сокращают до HITL, встраивает человеческое суждение в конкретные точки автоматизированного процесса. Человек может проверить предсказание модели, сравнить несколько креативных вариантов, исправить метку, отклонить вводящий в заблуждение ответ или передать сомнительный случай специалисту. Цель не в том, чтобы заменить автоматизацию ручной работой. Цель — решить, где человеческий интеллект добавляет достаточно контекста, ответственности или снижения риска, чтобы оправдать дополнительные время и деньги.
Для сооснователей и владельцев бизнеса это решение об архитектуре системы. Полностью автоматизированный процесс может быть быстрее и дешевле. Процесс с проверкой человеком — безопаснее и убедительнее. Правильный баланс зависит от того, что делает система, кого она может затронуть, насколько легко заметить ошибки и что происходит, когда система ошибается.
Этот баланс важен в технических приложениях ИИ, но не менее важен он и для продуктовых и маркетинговых решений. Команды используют обратную связь от людей, чтобы проверять сгенерированную ИИ рекламу, тестировать бизнес-идеи, сравнивать упаковку, оценивать материалы для магазинов приложений, просматривать ответы на опросы и решать, отражает ли машинное исследование то, во что на самом деле верят реальные клиенты. Автоматизация порождает возможности. Валидация с участием человека решает, какие из них станут решениями.
Здесь и нужен PickFu. PickFu — это платформа потребительских исследований, которая показывает ваши варианты — концепции продуктов, упаковку, рекламные креативы, названия, листинги — верифицированным респондентам из вашей целевой аудитории и возвращает письменную обратную связь за считаные часы. Платформа создана для одного конкретного момента «человека в контуре»: финального решения о том, что на самом деле выпускать. Генеративный ИИ может выдать сотню вариаций и предсказать, что людям понравится, но он не может быть покупателем. Именно люди покупают продукт, оценивают бренд и решают, заслуживает ли дизайн клика. Живая качественная обратная связь от реальных людей из целевой аудитории — это то, что ИИ может лишь имитировать, а имитация не является доказательством.
Что такое валидация с участием человека?
Валидация с участием человека — это процесс, в котором люди активно просматривают, проверяют, исправляют, утверждают, отклоняют или эскалируют результаты, полученные от автоматизированной системы. Автоматическая часть выполняет работу, которую трудно или неэффективно делать вручную в больших объёмах. Человеческая часть добавляет контекстное суждение там, где правил, исторических закономерностей или вероятностей модели недостаточно.
Возьмём систему поддержки клиентов, которая составляет ответы с помощью большой языковой модели. При высокой уверенности простые ответы могут уходить автоматически. Ответ, связанный со спором о возврате, юридической жалобой или вопросом безопасности, направляется сотруднику на утверждение. Система по-прежнему обрабатывает основной объём, но человек остаётся в процессе там, где цена ошибки выше.
Это не то же самое, что прогонять каждый результат через безликую ручную проверку. В хорошо спроектированном процессе участие человека имеет определённую цель. Проверяющие получают критерии, сигналы неопределённости, варианты решений и пути эскалации, а их исправления фиксируются, а не исчезают в чьей-то личной почте.
Валидация с участием человека встречается в ИИ и машинном обучении, аннотировании и разметке данных, клиентском сервисе, модерации контента, выявлении мошенничества, оценке синтетических данных, контроле качества ответов на опросы, продуктовых и креативных исследованиях, юридических и медицинских процессах, обработке естественного языка и компьютерном зрении. Общая нить: автоматизированная система создаёт или рекомендует что-то, а человек решает, приемлемо ли это для своего назначения.
Валидация — не то же самое, что обычная ручная проверка
Ручная проверка может быть неформальной. Кто-то читает результат, правит его и идёт дальше. Валидация более структурирована. Проверяющий сверяет результат с согласованным стандартом, а затем утверждает, исправляет, отклоняет, классифицирует или эскалирует его. В идеале решение становится частью журнала аудита, который позже поможет в обеспечении качества, отчётности или улучшении модели.
Различие важно, потому что само присутствие человека перед результатом ИИ ещё не делает процесс надёжным. Без чётких критериев два проверяющих придут к разным выводам. Спешащий проверяющий утвердит ошибку. Эксперт молча поправит результат, не записав, почему он был неверен. Ценность возникает, когда человеческий контроль сочетается с воспроизводимой системой.
Human-in-the-loop, human-on-the-loop и human-out-of-the-loop
Участие человека можно организовать по-разному. В системе human-in-the-loop (человек в контуре) человек напрямую участвует в принятии решения, и система может не иметь права выполнять некоторые действия без его одобрения. В системе human-on-the-loop (человек над контуром, иногда сокращённо HOTL) автоматика работает самостоятельно, а человек наблюдает и вмешивается при необходимости. Модель human-over-the-loop выводит людей на уровень управления: они задают цели и политики, оценивают результаты и решают, когда систему нужно изменить или остановить. В системе human-out-of-the-loop автоматика в штатном режиме работает без значимого вмешательства человека.
Ни один из этих вариантов не лучше других сам по себе. Правилу сортировки писем с низким риском не нужен сотрудник, утверждающий каждую классификацию. Автоматической системе отклонения платежей может понадобиться более строгий контроль, потому что ложные срабатывания блокируют добросовестных клиентов. Беспилотные автомобили находятся на дальнем краю спектра, где наблюдение человека над контуром ведётся непрерывно. Системе для медицинской визуализации могут требоваться подготовленные специалисты, интерпретирующие результаты до того, как те повлияют на лечение пациента. Вопрос не в том, должны ли люди участвовать всегда. Вопрос в том, где именно они должны участвовать и какими полномочиями обладать.
Почему валидация с участием человека важна
Главный аргумент в пользу проверки человеком — не в том, что люди всегда точнее машин. Это не так. Люди бывают непоследовательными, уставшими, предвзятыми или самоуверенными. Ценность в том, что люди и автоматизированные системы ошибаются по-разному. Модели машинного обучения стабильно обрабатывают большие объёмы, но спотыкаются, когда случай отличается от обучающих данных. Люди медленнее и менее последовательны, зато распознают нюансы, ставят под сомнение допущения и понимают, почему необычная ситуация требует другого ответа. Объедините их — и процесс станет устойчивее: страховочная сетка, в которой два типа сбоев редко совпадают.
Она ловит правдоподобные, но неверные результаты
Современные LLM выдают гладкие объяснения с необоснованными утверждениями. Генераторы изображений рисуют реалистичные детали, которых никогда не существовало. Предиктивные модели ставят точную оценку даже при слабых доказательствах. Поскольку такие результаты выглядят убедительно, они проходят через процесс, не вызывая подозрений.
Проверка человеком особенно ценна, когда правильность нельзя определить по синтаксису или форматированию. Ответ может быть грамматически безупречным и фактически неверным. Рекомендация товара может соответствовать истории покупок и при этом игнорировать ключевое ограничение. Резюме исследования может звучать проницательно и при этом преувеличивать то, что лежащие в его основе ответы на опрос на самом деле подтверждают. ИИ с участием человека даёт кому-то возможность задать вопрос, который система не может надёжно задать себе сама: имеет ли этот вывод смысл в контексте?
Она выявляет пограничные случаи
Автоматизированные системы лучше всего работают, когда новые случаи похожи на уже виденные. Проблемы возникают на границах: необычный запрос, новая схема мошенничества, редкий тип изображения, двусмысленная фраза. Эти пограничные случаи важны, потому что часто вскрывают слабые места всего процесса.
Допустим, система выявления мошенничества начинает блокировать законные транзакции клиентов, находящихся за границей. Общие показатели модели всё ещё выглядят хорошо, потому что затронутые транзакции — небольшая доля объёма. Но для клиента эта ошибка — отклонённая покупка, подорванное доверие и обращение в поддержку. Проверяющий, заметивший закономерность, может исправить отдельные случаи и указать на системную проблему, превратив разрозненные исключения в то, с чем может работать продуктовая команда.
Она делает риск видимым
Полностью автоматизированная система может казаться объективной, потому что одно и то же правило выполняется каждый раз. Но последовательность не гарантирует точности — система может масштабно повторять одну и ту же ошибку. Человеческий контроль создаёт возможность оспорить предсказания модели, разобрать странные результаты и заметить систематическую предвзятость. Когда проверяющие фиксируют, почему результат был изменён, организация узнаёт, где система сильна, где слаба и какие решения требуют большего контроля.
Документ NIST AI Risk Management Framework рекомендует организациям картировать риски, измерять производительность систем, управлять проблемами и выстраивать управление, соответствующее контексту. Его сопроводительное руководство также подчёркивает необходимость определить, где нужен человеческий контроль, и обучить людей, которые за него отвечают.
Она поддерживает соблюдение регуляторных требований и подотчётность
Некоторые регулируемые применения ИИ требуют полноценного человеческого контроля. Статья 14 Закона ЕС об ИИ, например, требует, чтобы высокорисковые ИИ-системы проектировались так, чтобы люди могли эффективно их контролировать, — то есть с реальными полномочиями интерпретировать результаты и вмешиваться, а не просто с кнопкой «утвердить» в конце непрозрачного процесса.
Она создаёт обратную связь для улучшений
Исправленный результат может сделать больше, чем устранить одну ошибку. Когда исправления структурированы и записаны, они возвращаются в жизненный цикл ИИ. Продуктовые команды замечают повторяющиеся категории сбоев. Дата-сайентисты улучшают правила или переобучают модели машинного обучения. Операционные команды пересматривают инструкции для проверяющих. Руководители корректируют пороги уверенности или решают, что некоторые действия вообще не стоит автоматизировать. Так циклы обратной связи связывают производственные показатели с улучшением системы. Без такого цикла одни и те же ошибки сотни раз исправляют вручную, а первопричина остаётся нетронутой.
Как работает валидация с участием человека

Процесс с участием человека обычно начинается с автоматически полученного результата, но важные проектные решения принимаются ещё до того, как этот результат попадёт к проверяющему. Команда решает, что требует валидации, как отбираются случаи, какую информацию видит проверяющий, какие действия ему доступны и как эти действия влияют на систему.
Типичный процесс выглядит так:
- Автоматизированная система выдаёт результат или рекомендуемое действие.
- Система присваивает оценку уверенности, категорию риска или правило валидации.
- Отобранные случаи направляются проверяющему.
- Проверяющий утверждает, редактирует, отклоняет или эскалирует результат.
- Решение и его обоснование записываются.
- Сложные случаи передаются старшему проверяющему или специалисту.
- Проверенные результаты идут в продакшен, отчётность, QA, обучение или исследования.
- Повторяющиеся исправления анализируются, чтобы улучшить модель или процесс.
- Постоянный мониторинг показывает, растёт ли качество, падает или меняется.
Последовательность проста, но каждый шаг связан с компромиссами.
Система выдаёт результат. Это может быть классификация, рекомендация, оценка, изображение, ответ, резюме или выполненное действие. Иногда это лишь предложение, иногда оно затронет клиента, если его не перехватить. Модель, рекомендующая тему письма, создаёт обратимое и недорогое решение. Модель, отклоняющая транзакцию или расставляющая приоритеты среди медицинских случаев, немедленно влияет на человека и требует более строгого контроля даже при такой же измеренной точности.
Результат отбирается на проверку. Проверка всего подряд даёт полное покрытие, но обычно убивает преимущества автоматизации в скорости и стоимости. Слишком редкая проверка пропускает серьёзные сбои. Большинство зрелых ИИ-процессов сочетают маршрутизацию по риску с выборочным контролем: результаты ниже заданных порогов уверенности уходят человеку, категории с высоким риском проверяются всегда, а случайная выборка «низкорисковых» результатов проверяется, чтобы заметить незаметное снижение качества.
Проверяющий оценивает результат по чётким критериям. Проверяющему нужно больше, чем сгенерированный результат: часто требуются исходный запрос, первоисточники, применимая политика, оценка неопределённости или предыдущие примеры. Именно здесь объяснимость становится практической. Оценка уверенности без контекста создаёт ложную уверенность; предсказание без подтверждающих данных вынуждает проверяющего гадать. Хорошие интерфейсы показывают ровно то, что нужно для конкретной задачи проверки.
Проверяющий утверждает, исправляет, отклоняет или эскалирует. Бинарное «утвердить или отклонить» часто слишком грубо. Проверяющему может понадобиться отредактировать ответ, сменить категорию, отметить нарушение политики или передать случай тому, у кого больше экспертизы. Эскалация — не провал. Это признание того, что у экспертизы и полномочий есть границы.
Исправление записывается. Решение гораздо полезнее, когда его причина фиксируется единообразно. Стандартизированные категории ошибок — фактически неверно, неполно, небезопасно, вне политики, недостаточно доказательств — упрощают анализ закономерностей. Эти записи образуют журнал аудита — он поддерживает проверки качества, управление и соблюдение регуляторных требований, а также показывает, повторяется ли одна и та же проблема.
Проверенные результаты улучшают систему. Исправления могут использоваться для обучения с учителем, активного обучения, изменения промптов, пересмотра правил или улучшения инструкций для проверяющих. Однако не каждое исправление стоит сразу возвращать в модель: проверяющие тоже ошибаются, а быстрые циклы обратной связи могут закрепить ошибочные допущения. Прежде чем стать обучающими данными, исправления должны пройти проверку качества. Смысл в том, чтобы превратить обратную связь от людей в структурированные доказательства, а не в одноразовую уборку.
Примеры валидации с участием человека
Идея становится понятнее на реальных процессах, которые выглядят по-разному в зависимости от того, что проверяется и что происходит при сбое системы.
Валидация результатов ИИ
SaaS-компания запускает ИИ-ассистента, который составляет ответы на вопросы клиентов. В пилоте ассистент хорошо справляется с типичными вопросами о функциях, но иногда выдумывает возможности продукта, когда документация скудна, — причём настолько уверенно, что клиенты могут не заметить. Первое решение компании — обязать сотрудников утверждать каждый черновик. Точность растёт, но время ответа почти не меняется, потому что сотрудники по-прежнему читают каждый ответ от начала до конца.
Тогда команда разделяет запросы по риску. Ответы, опирающиеся на утверждённую документацию, могут уходить автоматически при высоком пороге уверенности. Возвраты, вопросы безопасности, договорные обязательства и ответы без источников требуют одобрения сотрудника. Случайная выборка автоматических ответов проверяется каждую неделю. Изменилось не просто то, что добавили человека, — изменилось место, где этот человек входит в процесс, так что проверка сосредоточилась на неопределённости и последствиях, а не на объёме.
Валидация разметки данных
Ритейлер хочет обучить модель компьютерного зрения распознавать атрибуты товаров на каталожных фотографиях. Первая команда разметчиков маркирует одежду по длине рукава, вырезу, узору и цвету, и первая модель плохо справляется с многослойными образами и частично скрытыми товарами. Аудит показывает, что разметчики по-разному поняли правила: одни отмечали самый заметный предмет одежды, другие — все предметы на изображении.
Для спорных и необычных примеров добавляют этап повторной проверки. В инструкции включают положительные примеры, отрицательные примеры и сложные пограничные случаи, а согласованность проверяющих измеряют, прежде чем принимать новые метки. Выигрыш пришёл не от увеличения объёма разметки данных. Он пришёл от более чёткого определения эталона. Это типичный урок машинного обучения с участием человека: больший набор данных не становится лучше, если его метки непоследовательны.
Валидация ответов на опросы

Автоматизированные системы опросов умеют отмечать повторяющиеся IP-адреса, невозможное время заполнения, одинаковые ответы и очевидных ботов. Они слабее, когда ответ необычный, но настоящий. Респондент, который заполняет быстро, но пишет вдумчивые развёрнутые ответы, может быть ошибочно отсеян жёстким правилом по скорости, а другой, который тянет время, может сдать правдоподобные, но поверхностные ответы, сгенерированные ИИ-инструментом. Люди-проверяющие могут рассмотреть подозрительные записи в контексте, сравнивая развёрнутые ответы, их согласованность и поведение на протяжении всего опроса.
Именно вокруг такого контроля качества построен PickFu. Каждый ответ в PickFu приходит от верифицированного респондента-человека и содержит письменное объяснение, а проверки качества сочетают автоматику с проверкой людьми, потому что именно качество ответов, а не только их количество, определяет, можно ли доверять данным. Для команд, спрашивающих «где разместить опрос?», распространение — лишь первая проблема. Груда ответов от нежелательной аудитории или от ненадёжных участников не скажет вам ничего правдивого.
Разрыв виден на быстром тесте.
📊 Пример опроса: Мы попросили покупателей отличить реального клиента, сравнив обобщённый ответ в духе ИИ и конкретный человеческий, — быстрая проверка того, выдают ли себя поверхностные или написанные ИИ ответы. Посмотреть тест.
Модерация контента
Системы модерации контента быстро отмечают возможные травлю, насилие, обнажённость или мошенничество. Очевидные случаи можно обрабатывать автоматически; зависящие от контекста обычно требуют человеческого суждения. Фраза, выглядящая угрожающе сама по себе, может быть частью новостного репортажа или обсуждения личной безопасности. Безобидный на вид пост может оказаться оскорбительным в связке с предыдущими сообщениями. Ошибка — считать, что модерация людьми устраняет предвзятость или непоследовательность. Модераторам нужны чёткие политики, примеры, пути эскалации, защита психологического благополучия и регулярная калибровка — иначе компания просто меняет неопределённость модели на неизмеренный разброс между проверяющими.
Выявление мошенничества
Платёжная платформа оценивает транзакции по сигналам устройства, истории, геолокации и известным схемам мошенничества. Агрессивные правила снижают потери от мошенничества, но увеличивают ложные срабатывания — добросовестным клиентам отказывают из-за необычной покупки, нового устройства или поездки за границу. Аналитики могут проверять дорогостоящие или неоднозначные случаи до необратимого действия, а их решения способны выявить новые схемы мошенничества, которые модель пропустила. Здесь ограничение — скорость: проверка, завершённая через три дня, бесполезна для клиента, стоящего на кассе. Архитектура системы должна учитывать и качество решения, и его сроки.
Медицинская, юридическая и финансовая проверка
Профессиональные сферы с высоким риском показывают, почему автоматизация и валидация должны идти вместе. В медицинской визуализации, например, модель компьютерного зрения может выделить область, заслуживающую внимания, но врач интерпретирует её вместе с историей пациента, качеством снимка и симптомами. Регуляторы FDA, Health Canada и британский MHRA назвали производительность связки «человек + ИИ», а не алгоритма самого по себе, руководящим принципом для медицинских устройств на основе машинного обучения. То же верно, когда ИИ-инструмент резюмирует договор или отмечает необычную финансовую активность: подготовленные специалисты по-прежнему проверяют выводы, прежде чем те повлияют на юридические права, кредит или отчётность. Проверка человеком не делает эти системы безрисковыми. Она добавляет уровень контроля там, где цена необоснованного вывода слишком высока для полной автоматизации.
Валидация продуктовых и маркетинговых решений
Валидация с участием человека нужна и до того, как компания запустит продукт, кампанию или элемент бренда. Генеративный ИИ может выдать десятки концепций упаковки, рекламных объявлений, названий, слоганов, изображений товаров и экранов приложений. Он оптимизирует под визуальные шаблоны или инструкции, но не может надёжно предсказать, что конкретная целевая аудитория поймёт, чему поверит и что предпочтёт.
Проверить это можно только реальной обратной связью от потребителей. Это и есть шаг с участием человека для таких решений, как тестирование дизайна упаковки, тестирование логотипа компании, тестирование ИИ-креативов, тестирование макетов, тестирование логотипа и дизайна, тестирование скриншотов и иконок для магазинов приложений, тестирование слоганов, тестирование названия бизнеса, тестирование названия бренда, рыночная валидация прототипа, а также сплит-тестирование на Amazon.
Представьте основателя, который с помощью ИИ генерирует шесть направлений упаковки для нового средства по уходу за кожей. Внутренняя команда предпочитает самый минималистичный дизайн, потому что он выглядит премиально. Опрос потребителей показывает, что из-за этого же дизайна трудно понять назначение продукта, тогда как менее эффектный вариант ясно доносит пользу и вызывает более сильное намерение купить. Это не доказывает, что победившая упаковка захватит рынок. Но выявляет проблему коммуникации до того, как компания запустит производственную партию. ИИ расширил набор вариантов; реальные люди решили, какие из них работают за пределами команды, которая их создала.
Именно здесь ключевое место PickFu. Люди, которые покупают ваш продукт, оценивают бренд и пролистывают вашу рекламу, — живые, поэтому финальная оценка упаковки, текстов, названий и дизайна тоже должна исходить от людей. ИИ может расширить набор вариантов и предсказать реакции, но предсказание — не решение о покупке. Качественная обратная связь от реальных людей из целевой аудитории — это сигнал, который на самом деле отражает поведение рынка, и единственное, что модель может лишь имитировать, но не заменить.
Валидация человеком и автоматическая валидация
Валидация человеком и автоматическая валидация решают разные задачи. Самые сильные процессы применяют каждую там, где у неё есть преимущество.
Вывод не в том, что человек должен проверять каждый результат. Это дорого и подталкивает проверяющих к механическому одобрению. Лучше отдать автоматике предсказуемую работу и направить внимание людей на неопределённость, последствия и новизну.
Когда стоит использовать валидацию с участием человека?
Валидация человеком окупается, когда ошибку трудно обнаружить автоматически или дорого исправить. Ответ ИИ, обращённый к клиенту, заслуживает больше внимания, чем внутренний мозговой штурм. Модель, ранжирующая кандидатов на вакансию, — больше, чем та, что сортирует внутренние файлы. Синтетическое резюме исследования — больше, если его представят как рыночные доказательства, а не просто используют для подготовки вопросов к обсуждению.
Задумайтесь о проверке человеком, когда:
- Ошибки могут навредить пользователям, клиентам, пациентам, кандидатам или сотрудникам.
- Результаты влияют на финансовые, юридические, медицинские, кадровые решения или решения о безопасности.
- Задача требует интерпретации, эмпатии, культурного контекста или предметной экспертизы.
- Система обрабатывает чувствительные или персональные данные.
- Модель новая, недавно изменённая или работает в незнакомой среде.
- Результат будет опубликован или показан напрямую клиентам.
- Регуляторные требования, договоры или внутренние политики требуют контроля.
- Система выдаёт убедительные результаты, которые трудно проверить.
- Вам нужны надёжные эталонные данные.
- Синтетические данные или исследование, сгенерированное ИИ, лягут в основу стратегического решения.
- Необычные случаи могут выявить сдвиги в поведении клиентов или злоумышленников.
- Автоматическое действие трудно или невозможно отменить.
Взвешивайте последствия вместе с частотой. Сбой, случающийся один раз на 10 000 случаев, всё равно может требовать строгого контроля, если этот один сбой причиняет серьёзный вред.
Когда валидация с участием человека может быть не нужна
Участие человека добавляет затраты, задержки и сложность. Его не стоит прикручивать лишь для того, чтобы процесс звучал ответственно. Низкорисковые повторяющиеся задачи обычно лучше обслуживаются автоматическими правилами и периодическими выборочными проверками: проверке формата файлов, поиску дубликатов, контролю обязательных полей и детерминированным расчётам редко нужен человек, утверждающий каждый результат.
Проверка человеком мало что добавляет, когда задача низкорисковая и легко обратимая, правильность определяется чёткими правилами, редкие ошибки допустимы и быстро обнаруживаются, результат — внутренний черновик, который всё равно проверят позже, автоматическое тестирование уже даёт хорошее покрытие, у проверяющих нет доступа к дополнительному контексту, задержка навредит сильнее вероятных ошибок или человек, скорее всего, будет штамповать одобрения без настоящей оценки. Команде, генерирующей идеи внутренних заголовков, не нужен комитет, изучающий каждую строку. Настоящий вопрос — улучшает ли формализованный шаг проверки результат настолько, чтобы оправдать создаваемую нагрузку.
Преимущества валидации с участием человека
Преимущества реальны, но зависят от того, как спроектирован процесс.
Выше точность там, где важен контекст. Проверяющий может сопоставить результат с фактами, политиками и ситуационным контекстом, которых модель никогда не получала. Это особенно полезно с большими языковыми моделями, где гладкий текст может скрывать фактические или логические ошибки.
Безопаснее внедрение ИИ. Проверка человеком может остановить сомнительные или значимые результаты до того, как они дойдут до пользователей, и выявить типы сбоев во время ограниченного пилота — а команды редко знают все типы сбоев заранее.
Лучше работа с нюансами. Потребительские предпочтения, юмор, культурные отсылки и тон бренда не сводятся к чётким правилам. Обратная связь от людей помогает понять, почему вариант работает, а не только прошёл ли он техническую проверку. ИИ может генерировать технически безупречные изображения товаров, которые покупатели всё равно воспринимают как нереалистичные или не соответствующие бренду за такую цену. Тест предпочтений выявляет реакции, недоступные метрикам качества изображения.
Качественнее данные для обучения и оценки. Проверенные людьми примеры могут стать метками, бенчмарками или оценочными наборами для обучения с учителем — при условии, что качество аннотирования держится. Плохо подготовленные проверяющие создают непоследовательные метки, вредящие модели, поэтому контроль качества должен распространяться и на людей.
Непрерывное улучшение. Хорошо выстроенные циклы обратной связи показывают командам, где автоматика продолжает сбоить, чтобы менять промпты, пороги, обучающие данные или правила на основе фактов. Со временем типичные случаи требуют всё меньше вмешательства, а новые или высокорисковые продолжают получать внимание.
Больше доверия и подотчётности. Люди охотнее пользуются ИИ-системой, когда понимают её ограничения и знают, что существует реальная эскалация. Доверие не рождается из расплывчатого «в процессе участвует человек». Оно рождается из объяснения, что делает система, какие решения проверяются, как можно оспорить ошибки и кто несёт ответственность.
Ограничения и риски
Проверка человеком не является автоматически точной, нейтральной или масштабируемой. Плохо спроектированный контроль добавляет затраты, не снижая риск.
Предвзятость проверяющих. Проверяющие привносят собственные допущения и стимулы, и человек может исправить один вид предвзятости модели, добавив другой. Разнообразные команды, чёткие критерии, анализ разногласий и периодические аудиты снижают этот риск, но ни один процесс не устраняет субъективность полностью.
Непоследовательные решения. Два знающих человека могут по-разному прочитать один и тот же результат, особенно в вопросах тона, безопасности и творческих предпочтений. Измеряйте согласованность проверяющих, а не предполагайте консенсус; низкая согласованность часто сигнализирует о слабой подготовке, неясных инструкциях или по-настоящему неоднозначной задаче.
Усталость проверяющих. Проверка больших объёмов становится монотонной, и люди начинают полагаться на модель или одобрять результаты, потому что исправлять их — больше работы. Это автоматизационная предвзятость: модель по умолчанию считается правой. Помогают более короткие очереди, ротация, удобные интерфейсы и приоритет значимых решений. Просить людей проверять тысячи почти одинаковых низкорисковых результатов — редко хорошее применение человеческого интеллекта.
Медленная обработка и высокая стоимость. Проверка может стать узким местом с растущими очередями и задержкой ответов. Решение — выборочный контроль по риску: сосредоточьте проверку там, где она меняет результат.
Конфиденциальность и безопасность. Проверяющие могут видеть персональные, медицинские, финансовые или конфиденциальные сведения. Ограничьте доступ необходимым, скрывайте данные, где возможно, логируйте действия проверяющих и тщательно проверяйте внешних подрядчиков по разметке, поскольку чувствительные данные могут выйти из-под вашего контроля.
Излишняя вера в человеческое суждение. Добавление человека может создать ложное спокойствие. Проверяющий без нужной экспертизы может быть не лучше модели в обнаружении ошибки. Печать «одобрено человеком» — не доказательство истины; командам по-прежнему нужны оценочные наборы, анализ ошибок и мониторинг результатов.
Циклы обратной связи, закрепляющие ошибки. Исправления людей часто принимают за эталон, но проверяющие могут разделять те же ошибочные допущения. Если скармливать модели каждое исправление, эти допущения закрепятся. Проверяйте обратную связь от людей на последовательность и репрезентативность, прежде чем она станет обучающими данными.
Лучшие практики валидации с участием человека

Надёжный HITL-процесс начинается с операционной ясности. Проверяющие должны знать, что они проверяют, что считается приемлемым и что делать, когда они не уверены.
Определите чёткие критерии валидации. «Убедитесь, что ответ хороший» — бесполезная формулировка. Назовите измерения: ответ ИИ можно проверять на фактическую точность, релевантность, полноту, безопасность, тон, опору на источники и соответствие политике. Концепцию упаковки — на понятность, убедительность, отличимость и намерение купить. Критерии должны отражать желаемый результат: привлекательный дизайн всё равно провалится, если покупатели неверно поймут, что делает продукт.
Обучайте проверяющих на реалистичных примерах. Включайте очевидные удачи, очевидные провалы и неоднозначные случаи и показывайте, почему было принято решение, а не только какую кнопку нажали. Особенно полезны калибровочные упражнения, где несколько проверяющих оценивают одни и те же случаи и обсуждают расхождения.
Измеряйте согласованность проверяющих. Межэкспертная согласованность показывает, насколько единообразно проверяющие применяют критерии. Низкая согласованность — не всегда плохая работа: возможно, задача субъективна или информации недостаточно, а это ценный продуктовый инсайт. Реагируйте уточнением определений, добавлением примеров или эскалацией отдельных категорий.
Используйте правила эскалации. Проверяющие должны знать, когда не принимать решение самим: исключения из политики, юридический риск, личная безопасность, незнакомый контент или разногласия экспертов. Пути эскалации защищают и пользователя, и проверяющего.
Выбирайте стратегически. Проверяйте все случаи с высоким влиянием или высокой неопределённостью и случайным образом отбирайте менее рискованные результаты, чтобы находить скрытые проблемы. Выборка должна меняться со временем: широкая проверка при запуске, более лёгкая рутинная — когда показатели стабилизируются.
Отслеживайте качество во времени. Разовое валидационное исследование не гарантирует будущих результатов. Поведение клиентов меняется, мошенничество эволюционирует, политики обновляются, модели дрейфуют. Отслеживайте частоту ошибок, согласованность, закономерности эскалации и итоги по версиям модели на протяжении всего жизненного цикла ИИ.
Ведите содержательные журналы аудита. Записывайте входные данные, результат, версию модели, оценку уверенности, решение проверяющего, исправление, обоснование и время. Хороший журнал отвечает на будущие вопросы: почему это утвердили? Какая версия это выдала? Была ли у проверяющего нужная информация? Повторяется ли эта ошибка? Журналы должны строиться для расследований, а не собираться ради самих себя.
Защищайте чувствительные данные. Давайте проверяющим только то, что требует задача. Маскируйте персональные идентификаторы, держите доступ ролевым и контролируемым и задайте чёткие сроки хранения, чтобы проверка не превращалась в бессрочный архив чувствительных данных.
Валидация с участием человека для ИИ-систем
ИИ с участием человека особенно полезен, потому что результаты ИИ вероятностны, убедительны и трудно проверяемы. Традиционное ПО следует явным правилам: одинаковый ввод — одинаковый результат. Генеративный ИИ и многие модели машинного обучения выводят закономерности из данных и выдают результаты по вероятности. Такая гибкость позволяет LLM и другим системам решать сложные задачи, но она же затрудняет исчерпывающее тестирование по правилам.
Слой с участием человека может поддерживать ИИ-процессы: проверять предсказания модели, сгенерированные тексты и изображения, ловить галлюцинации, оценивать безопасность и соответствие политикам, создавать и валидировать эталонные наборы данных, отслеживать дрейф модели, исправлять ошибки аннотирования и утверждать значимые действия. Архитектура должна соответствовать системе: инструменту обработки естественного языка может требоваться фактическая и контекстная проверка, модели компьютерного зрения — специалисты по изображениям для неуверенных классификаций, и чем больше полномочий у системы, тем важнее определить точки вмешательства.
Валидация с участием человека и ИИ-агенты
ИИ-агенты выполняют несколько действий на пути к цели, а не выдают один изолированный результат. Они ищут в базах данных, вызывают инструменты, обновляют записи, связываются с клиентами и инициируют транзакции — и это умножает риск, потому что одно неверное допущение может определить несколько последующих действий. Контроль над ИИ-агентами может включать одобрение перед значимыми вызовами инструментов, лимиты расходов, ограниченные разрешения, контрольные точки после ключевых решений и автоматическую эскалацию при росте неопределённости. Агент для планирования путешествий может сам сравнить рейсы и подготовить маршрут, а затем запросить явное одобрение перед покупкой невозвратного билета. Скорость на этапе исследования, человеческий контроль над необратимым шагом. Контроль должен быть встроен в разрешения агента, а не прикручен после внедрения.
Пороги уверенности и выборочная проверка
Не каждому результату нужно одинаковое вмешательство. Система может направлять предсказания с низкой уверенностью людям, а с высокой — принимать автоматически, но уверенность нужно сверять с реальными результатами, потому что модель может уверенно ошибаться. Калибруйте пороги на исторических данных и пересматривайте их по группам клиентов: единый глобальный порог может скрывать слабые результаты на редких случаях. Случайная выборка результатов с высокой уверенностью по-прежнему важна, поскольку проверяет, соответствует ли уверенность модели реальной точности.
Активное обучение
Активное обучение — это подход в машинном обучении, при котором система отмечает примеры, разметка которых человеком была бы наиболее информативной: случаи, где она не уверена, где модели расходятся или где данных мало. Это делает аннотирование эффективнее, концентрируя усилия людей там, где новые метки помогают больше всего. Компромисс: неуверенные примеры часто необычно сложны, поэтому проверяющим нужны чёткие инструкции, а полученные данные нельзя считать верными только потому, что их дал человек.
Машинное обучение с участием человека
В машинном обучении с участием человека, как понятно из названия, люди участвуют на всех этапах: сбор данных, обучение, оценка, внедрение и мониторинг. Они определяют категории меток, аннотируют примеры, разрешают разногласия, разбирают ошибки модели, валидируют предсказания, исследуют изменения показателей, отмечают вредные результаты и решают, готова ли модель к более широкому использованию. Вклад человека становится частью того, как система учится, а не единственным шагом одобрения.
Обратная связь от людей и RLHF
Обучение с подкреплением на основе обратной связи от людей, или RLHF, — это один из методов использования человеческих предпочтений для формирования поведения модели. В упрощённом виде люди сравнивают или ранжируют результаты модели, и эти предпочтения обучают модель вознаграждения, которая направляет дальнейшее обучение, — подход, который описала OpenAI для обучения моделей, следующих инструкциям. RLHF связан с работой «человека в контуре», но это не одно и то же. HITL-валидация может происходить в продакшене, QA, исследованиях или при утверждении; RLHF — метод обучения. Можно проводить HITL-валидацию без RLHF, а можно обучить модель с помощью RLHF, и ей всё равно понадобится проверка человеком после внедрения.
Продуктовые исследования с участием человека для ИИ
Продуктовые исследования с участием человека для ИИ применяют тот же принцип к продуктовым и маркетинговым решениям: ИИ помогает командам генерировать и организовывать варианты, а реальные потребители проверяют, как эти варианты воспринимаются.
Это особенно важно для компаний на ранней стадии, потому что генеративные инструменты обрушили стоимость создания концепций. Основатель может за один день сделать десять направлений логотипа, пять макетов посадочной страницы или двадцать вариантов рекламы. Узкое место сместилось с производства на отбор, а внутренние команды плохо справляются с этим отбором, потому что слишком много знают о продукте. Они мысленно достраивают неясные формулировки, считывают тонкие отсылки к бренду и не замечают сомнений, очевидных для нового клиента. Обратная связь от людей возвращает взгляд со стороны. Это одна из самых практичных альтернатив фокус-группам для небольшой команды: быстрее и дешевле, чем собирать группу людей в одном помещении, и нацелена именно на вашу целевую аудиторию.
От тестирования ИИ-креативов к рыночным доказательствам

Суть тестирования ИИ-креативов: команда с помощью ИИ генерирует несколько направлений, а затем спрашивает целевых потребителей, какая версия самая понятная, самая заслуживающая доверия или с наибольшей вероятностью получит клик. Сформулируйте исследовательский вопрос до запуска: вопрос о том, какой дизайн людям «нравится», выдаст победителя, но не скажет, служит ли он бизнес-цели. Более сильные вопросы звучат так: какая реклама яснее всего доносит пользу? Какая упаковка выглядит убедительно за заявленную цену? Какая иконка приложения читается в маленьком размере? Какой слоган соответствует позиционированию? Обратная связь проверяет критерий решения, а не вкус дизайнера.
Вот как это выглядит на реальных данных. Мы сгенерировали две рекламные концепции для вымышленного увлажняющего крема — глянцевый рендер продукта и лайфстайл-кадр, отталкивающийся от проблемы, — и протестировали их на покупателях с сухой кожей.
📊 Пример опроса: Две сгенерированные ИИ рекламы увлажняющего крема, протестированные на 15 покупателях из США с сухой кожей. Посмотреть сравнение.
Что показали результаты:
- Глянцевый рендер продукта победил со счётом 60% против 40%, обойдя лайфстайл-версию.
- «Увлажнение на весь день» — самая частая причина кликнуть: конкретная польза победила настроение.
- Те 40%, что выбрали лайфстайл-рекламу, хотели видеть «настоящих людей» и реальные результаты на коже, так что проигравшая концепция всё же несла сигнал, который стоит проверить следующим.
Такой близкий расклад — и есть суть. ИИ выдал оба варианта за минуты; реальные люди показали, что ясное обещание пользы обошло привлекательную сцену и что часть аудитории по-прежнему хочет видеть человеческое лицо. Ни один из этих выводов не был доступен изнутри команды.
Мини-кейс: тестирование логотипа компании
B2B-компания, разрабатывающая ПО, создаёт несколько концепций логотипа с помощью модели генерации изображений. Основателям нравится детализированный символ, который должен олицетворять связность, аналитику и автоматизацию. В ходе тестирования логотипа и дизайна потенциальные клиенты раз за разом описывают знак как логотип медицинской компании. Более простой вариант значит для основателей меньше, но рынком считывается точнее, поэтому компания меняет направление до вложений в полноценную визуальную айдентику.
Изменился не только логотип — команда обнаружила разрыв между задуманным смыслом и воспринимаемым. Объяснение не спасёт символ, который должен работать ещё до того, как объяснение прозвучит. Поэтому концепции логотипа стоит тестировать на людях, которых не было в комнате, когда их создавали.
Мини-кейс: тестирование скриншотов и иконки для магазина приложений
Команда приложения готовит запуск со скриншотами, сосредоточенными на функциях. Изображения отполированы, но первый экран перегружен несколькими элементами интерфейса и длинным заголовком. В тестировании скриншотов и иконок для магазина приложений респонденты быстрее понимают более простой макет в стиле конкурентов и предпочитают иконку, которую дизайнеры отвергли как слишком обычную. Команда перестраивает первый скриншот вокруг одной ключевой пользы и выбирает более узнаваемую иконку.
Урок не в том, что традиционный дизайн всегда побеждает. А в том, что магазины приложений — быстрая среда с низким вниманием, где мгновенное понимание часто важнее объёма показанной информации.
Обратная связь от людей для оригинального GEO- и SEO-контента
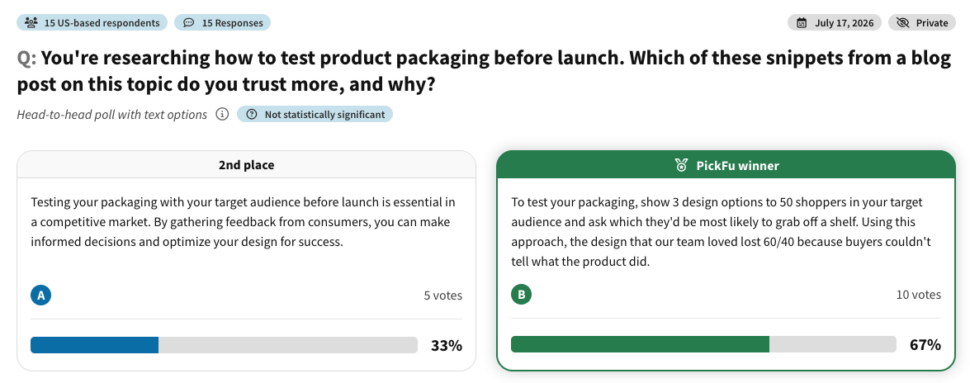
ИИ может ускорить исследование тем, черновики, FAQ и переупаковку контента, но он же склонен воспроизводить обобщённые формулировки, которыми уже полон интернет. Командам, которые задаются вопросом, как создавать оригинальный контент для GEO и SEO — нужно больше, чем статья, сгенерированная ИИ: доказательства, опыт и точки зрения, которые конкурирующие страницы не смогут воспроизвести из тех же публичных источников.
Здесь и появляется контентное исследование с участием человека: опросы целевых клиентов об их критериях выбора, интервью с экспертами, проверка того, какие объяснения работают, сбор оригинальных ответов на опросы и публикация собственных графиков и выводов. ИИ может организовать и объяснить этот материал; человеческие данные дают контенту что-то оригинальное, что можно сказать.
Мы проверили это утверждение на практике.
📊 Пример опроса: Мы протестировали два объяснения одной и той же темы — обобщённое в духе ИИ и отредактированное экспертом с результатом из первых рук, — чтобы увидеть, какому читатели доверяют больше. Посмотреть тест.
Валидация с участием человека для синтетических респондентов и синтетических данных
У синтетических исследований есть сильные стороны: такие данные помогают командам изучать сценарии, тестировать ПО, защищать конфиденциальность или заполнять пробелы там, где реальных примеров мало. Синтетические респонденты могут имитировать возможные реакции аудитории на основе закономерностей, усвоенных ИИ-моделью.
Риск возникает, когда симуляцию путают с наблюдением. Синтетическая персона может сформулировать правдоподобное возражение против продукта, и это поможет подготовить более точные исследовательские вопросы, но не установит, как часто реальные клиенты разделяют это возражение и насколько сильно оно влияет на их покупки.
Валидация человеком улучшает синтетические исследования: она сравнивает синтетические ответы с известными данными о клиентах, выявляет стереотипные или упрощённые персоны, проверяет обоснованность утверждений и отделяет мозговой штурм от доказательств. В этом суть противопоставления синтетических респондентов и реальной обратной связи от потребителей, и его не стоит подавать как соревнование, где одно заменяет другое.
Синтетические результаты быстры, дёшевы и по-настоящему полезны для некоторых задач: широкой сегментации, общих ориентировочных оценок и генерации гипотез, которые стоит проверить. Они становятся ненадёжнее ровно там, где решение становится конкретным: тонкие творческие предпочтения (попросить человека сравнить три дизайна и объяснить, почему побеждает один), детальные качественные реакции и прогнозы о том, как конкретная аудитория поведёт себя на самом деле.
Точность тоже нестабильна: один и тот же синтетический метод может точно повторить человеческие результаты на одной задаче и сильно промахнуться на следующей. Поэтому синтетический ответ лучше считать гипотезой, а не доказательством, пока его не подтвердят реальные люди.
Допустим, команда обдумывает новую подписку на наборы для готовки. Они спрашивают LLM, выступающую в роли синтетической персоны целевого покупателя, что помешало бы человеку подписаться, — быстрый способ получить гипотезу. Ответ обычно начинается с цены. Это разумная стартовая догадка, но синтетические персоны склонны переоценивать цену и недооценивать более тихие препятствия вроде «а впишется ли это в мой распорядок?»

Выяснить это можно, задав тот же вопрос реальным людям из вашей целевой аудитории — это и есть шаг валидации, для которого создан PickFu. Вот та же постановка в виде реального опроса:
📊 Пример опроса: Тот же вопрос о наборах для готовки — что сильнее всего удержало бы вас от подписки? — задан реальным потребителям вместо синтетической персоны. Запустите его на PickFu, а затем сравните реальные ответы с синтетической догадкой. Посмотреть тест.
Чтобы обозначить границу: валидация человеком может сделать синтетические результаты реалистичнее и отметить необоснованные выводы, но не может превратить смоделированные мнения в доказательство того, что реальные люди их разделяют. Опросы PickFu отправляются верифицированным респондентам-людям — реальным людям из вашей целевой аудитории, а не сгенерированным ИИ, — поэтому это способ сверить синтетическую гипотезу с реальными реакциями, а не ещё одна симуляция поверх первой.
И по мере того как ИИ наполняет каждый канал всё новыми вариациями, которые нужно перебирать, такая реальная человеческая валидация значит больше, а не меньше: аудитория всего этого сгенерированного ИИ контента по-прежнему состоит из людей.
Как построить процесс валидации с участием человека
Полезный процесс начинается с решения, а не с технологии. Сначала определите, что вы хотите защитить или улучшить — фактическую точность, безопасность клиентов, ясность креатива, снижение мошенничества, качество исследований, соответствие политикам или качество обучающих данных, — а затем спроектируйте подходящий уровень участия человека.
- Определите, что требует валидации. «Проверять ИИ-контент» — слишком широко. «Убедиться, что ответы клиентам подтверждены утверждённой документацией по продукту» — рабочая формулировка.
- Классифицируйте результаты по риску. Оцените последствия ошибки, её обратимость, кого она затронет и насколько легко её заметить. Модель «низкий/средний/высокий» работает, если уровни отражают реальный контекст вашего бизнеса.
- Решите, каким результатам нужна проверка человеком. Высокий риск может требовать полной проверки; средний — маршрутизации по уверенности или триггерам; низкий может работать автоматически с периодическими выборками.
- Создайте инструкции по валидации. Задокументируйте, что проверять, на какие данные опираться и что считается утверждением, исправлением, отклонением или эскалацией, с примерами из реальных условий.
- Обучите и откалибруйте проверяющих. Пусть несколько человек оценят одни и те же пилотные случаи, затем сравните и обсудите. Это выявит неясные критерии до того, как они попадут в продакшен.
- Проведите контролируемый пилот. Начните с ограниченного объёма или набора действий. Измерьте, где система ошибается, как часто вмешиваются проверяющие и не создаёт ли процесс недопустимых задержек.
- Измеряйте согласованность и результаты. Высокая доля одобрений сама по себе не доказывает успех: возможно, проверяющие одобряют слишком легко или получают случаи, которым внимание вообще не требовалось.
- Добавьте пути эскалации. Укажите, какие случаи требуют специалистов или юридической проверки, и не наказывайте проверяющих за эскалацию при обоснованных сомнениях.
- Логируйте решения и исправления. Фиксируйте структурированные причины, чтобы повторяющиеся закономерности становились видны, с достаточным контекстом для восстановления произошедшего.
- Улучшайте модель, правила или процесс. Используйте проверенные выводы для устранения первопричин: промптов, исходных данных, порогов, политик, переобучения или клиентского опыта.
- Регулярно пересматривайте. Возвращайтесь к архитектуре после изменений модели, новых сценариев использования, обновления политик, смены аудитории или появления новых типов сбоев.
Метрики валидации с участием человека
Метрики должны показывать, улучшает ли участие человека решения, а не просто заняты ли проверяющие. Полезные показатели: точность и частота ошибок, доля ложноположительных и ложноотрицательных результатов, согласованность проверяющих, доля исправлений и эскалаций, доля отмен после старшей проверки, время обработки, стоимость одного проверенного элемента, процент проверенных высокорисковых результатов, дрейф качества во времени и улучшение модели после обратной связи.
Правильная комбинация зависит от процесса. Система выявления мошенничества может ставить во главу угла ложноположительные и ложноотрицательные результаты, потому что важны и трение для клиентов, и потери от мошенничества. Контентный процесс — долю фактических исправлений и время публикации. Тест креатива — понимание, предпочтение и намерение купить по сегментам.
Читайте метрики вместе: падение доли исправлений может означать, что модель стала лучше, а может — что проверяющие перестали вникать. Само измерение требует интерпретации, и это ещё одно место, где человеческое суждение остаётся необходимым.
Типичные ошибки валидации с участием человека
Самая частая ошибка — считать, что любое участие человека создаёт надёжный контроль. Человек без времени, экспертизы, контекста или полномочий — не более чем формальный утверждающий. Другие распространённые ошибки:
- Расплывчатые инструкции или проверка каждого результата независимо от риска
- Слишком редкая проверка, не выявляющая системных проблем
- Отношение ко всем предсказаниям как к одинаково значимым
- Отказ от измерения согласованности проверяющих или игнорирование усталости и автоматизационной предвзятости
- Отношение к мнению одного проверяющего как к неоспоримому эталону
- Сбор исправлений без возврата их в процесс
- Смена моделей без обновления критериев проверки
- Доступ проверяющих к чувствительным данным без необходимости
- Использование синтетической валидации без реальных бенчмарков
- Представление результата как «проверенного человеком» без описания метода
Допустим, маркетинговая команда с помощью LLM готовит 100 рекламных постов для соцсетей и просит одного сотрудника утвердить их за полдня. Формально процесс содержит человеческий контроль, но объём вынуждает бегло просматривать, у проверяющего нет данных о целевых клиентах, и никакие причины не фиксируются.
Более сильный процесс автоматически убирает дубликаты и нарушения политики, поручает команде отобрать стратегически разные концепции и тестирует их на целевых потребителях. Усилия людей идут сначала на экспертную курацию, затем на рыночную валидацию. Меньше проверки, лучше доказательства.
Чек-лист валидации с участием человека
Используйте его при оценке нового или существующего процесса:
- Чётко ли определена цель валидации и привязана ли она к конкретному бизнес-решению?
- Классифицированы ли результаты по риску и последствиям?
- Понятно ли, какие случаи требуют проверки человеком, и проверены ли пороги уверенности на реальных результатах?
- Задокументированы ли инструкции для проверяющих, включая сложные и неоднозначные примеры?
- Обучены ли и откалиброваны ли проверяющие, и хватает ли им контекста для решения?
- Измеряется ли согласованность проверяющих?
- Могут ли проверяющие редактировать, отклонять и эскалировать, и направляются ли высокорисковые случаи специалистам?
- Логируются ли решения и исправления, и защищены ли чувствительные данные?
- Проходят ли аудит случайные выборки автоматических одобрений?
- Используются ли повторяющиеся ошибки для улучшения модели или процесса?
- Отслеживается ли качество по версиям модели и группам клиентов?
- Измеряются ли усталость и нагрузка проверяющих?
- Раскрыты ли ограничения процесса, и есть ли конкретный ответственный за результат?
Настоящая цель валидации с участием человека
Валидацию с участием человека обычно подают как технический метод повышения точности ИИ. Для руководителей бизнеса её полезнее понимать как способ распределять суждение. Автоматизация должна брать на себя работу, выигрывающую от скорости, последовательности и масштаба. Люди должны участвовать там, где контекст, ответственность, неопределённость или последствия делают их суждение стоящим своей цены.
Этот принцип работает, проверяете ли вы сгенерированный ИИ ответ клиенту, сравниваете варианты дизайна или решаете, отражает ли синтетическое исследование реальное поведение потребителей. Цель — не человек за каждой машиной. Цель — не дать эффективности стать оправданием слабых доказательств, невидимого риска или решений, которые никто не может объяснить.
Если ваше следующее решение касается сгенерированных ИИ креативов, упаковки, названий или концепций продукта, шаг с участием человека — это быстрый тест на реальных людях до того, как вы потратите бюджет.
Создайте бесплатный аккаунт PickFu и запустите свой первый опрос — начните собирать реальные человеческие инсайты в поддержку ваших бизнес-решений.
Часто задаваемые вопросы
Как устроен процесс проверки с участием человека?
Он начинается, когда автоматизированная система выдаёт результат, предсказание или рекомендуемое действие. Система направляет отобранные случаи человеку на основе риска, неопределённости, правил выборки или порогов уверенности. Проверяющий сверяет результат с заданными критериями, а затем утверждает, исправляет, отклоняет или эскалирует его. Решение записывается в журнал аудита и может использоваться для улучшения будущих показателей модели, политик, обучающих данных или ИИ-процессов.
Чем помогает оценка с участием человека?
Она помогает командам находить фактические ошибки, неоднозначные результаты, небезопасные рекомендации, предвзятость, галлюцинации и пограничные случаи, которые пропускает автоматическая оценка. Она также показывает, почему модель ошиблась, чтобы команда могла улучшить данные, промпты, правила, интерфейс или модели машинного обучения, а не исправлять одну и ту же производственную ошибку снова и снова.
Что такое ИИ с участием человека?
Это подход, при котором люди участвуют в разработке, оценке, эксплуатации или контроле ИИ-системы: размечают данные, валидируют предсказания, утверждают действия, разрешают сомнительные случаи, дают обратную связь или решают, когда систему нужно изменить или остановить. Степень участия зависит от сложности и риска задачи.
В чём преимущества ИИ с участием человека?
Выше контекстная точность, лучше обработка необычных случаев, безопаснее внедрение, качественнее обучающие данные, больше подотчётности и полезнее циклы обратной связи. Всё это зависит от экспертизы проверяющих, чётких инструкций, правильной выборки и мониторинга качества — проверка человеком не становится надёжной автоматически лишь потому, что в ней участвует человек.
Как участие человека применяется к ИИ-агентам?
Контроль с участием человека может требовать одобрения до того, как агент совершит значимое действие: отправит внешнее сообщение, изменит записи клиентов, совершит покупку, переведёт деньги или удалит данные. Менее значимые действия могут оставаться автоматическими, так что агент исследует и готовит рекомендацию, а человек сохраняет полномочия над необратимыми или высокорисковыми шагами.
Какие есть примеры валидации с участием человека в ИИ?
Сотрудники, проверяющие сгенерированные ИИ ответы клиентам; аналитики, разбирающие подозрения в мошенничестве; модераторы, оценивающие неоднозначный контент; врачи, интерпретирующие результаты медицинской визуализации; исследователи, валидирующие синтетические ответы на опросы; потребители, оценивающие сгенерированную ИИ рекламу или макеты продуктов. Роль человека может заключаться в утверждении, исправлении, отклонении, объяснении или эскалации.
В чём разница между human-in-the-loop и human-on-the-loop?
Human-in-the-loop обычно означает, что человек напрямую участвует в решении, например утверждает результат перед его использованием. Human-on-the-loop означает, что система работает самостоятельно, а человек наблюдает и вмешивается при необходимости. Что подходит, зависит от скорости, автономности и риска системы.
Может ли валидация с участием человека устранить предвзятость ИИ?
Она может помочь выявить и снизить предвзятость, но не гарантирует её устранения. Проверяющие могут привносить собственную предвзятость, а команды — разделять допущения, уже заложенные в модель или данные. Чёткие критерии, разнообразие в оценке, анализ результатов и независимые аудиты остаются необходимыми.
Как измерить качество валидации человеком?
Через согласованность проверяющих, долю исправлений и ошибок, долю эскалаций, отмены после старшей проверки, результаты аудитов, время обработки и сравнение с эталоном, проверенным экспертами. Самый важный показатель — улучшает ли участие человека тот реальный результат, ради которого система была создана.