- 300+
- 个合成受众,覆盖 25 个产品类目
- ~200
- 项人群标签,构成每位合成受访者
- 100s
- 份 PickFu 历史问卷,支撑每一个结果
- < 1 min
- 从提问到结果
使用流程
合成测试如何融入您的工作流程
合成受访者决定测什么,真实用户决定怎么做。
- 1
从一个初步想法或多个选项开始
分享一个粗略的概念,或生成多个名称、标语、图片或其他选项。
- 2
用合成受众筛选
不到一分钟出结果。把八个名字缩到值得用真实用户测试的两个。
- 3
打磨胜出的选项
根据分歧背后的主题进行优化,再测一次。想跑多少轮都可以。
- 4
用真实用户确认
PickFu 智能体会针对您最强的选项,提供一份可直接发布的真人问卷,每位受访者都会给出文字反馈。
为什么这不等于直接问 ChatGPT
让通用 AI 扮演一位狗主人,它会凭空编造一个。我们则从受访者样本库中真实的狗主人出发。
从真实的人出发
约 200 项人群标签,加上过往 PickFu 问卷中的真实选择,都来自与您想触达的人群相似的受访者。
成为一位合成受访者
它预测这类人会怎么选。它没有自己的观点。
数十位一起投票
一个结果是数十个独立预测汇总而成的投票,而不是某个 AI 对“它觉得人们想要什么”的概括。
已与数百份 PickFu 历史问卷中真实用户的选择进行校验
两种使用方式
两种方式都可以通过网页版或 Slack 中的 PickFu 智能体使用,也可以通过 Claude 等工具中的 PickFu MCP 使用。生成、测试、优化、再测试,全部在您现有的工具里完成。
对比测试
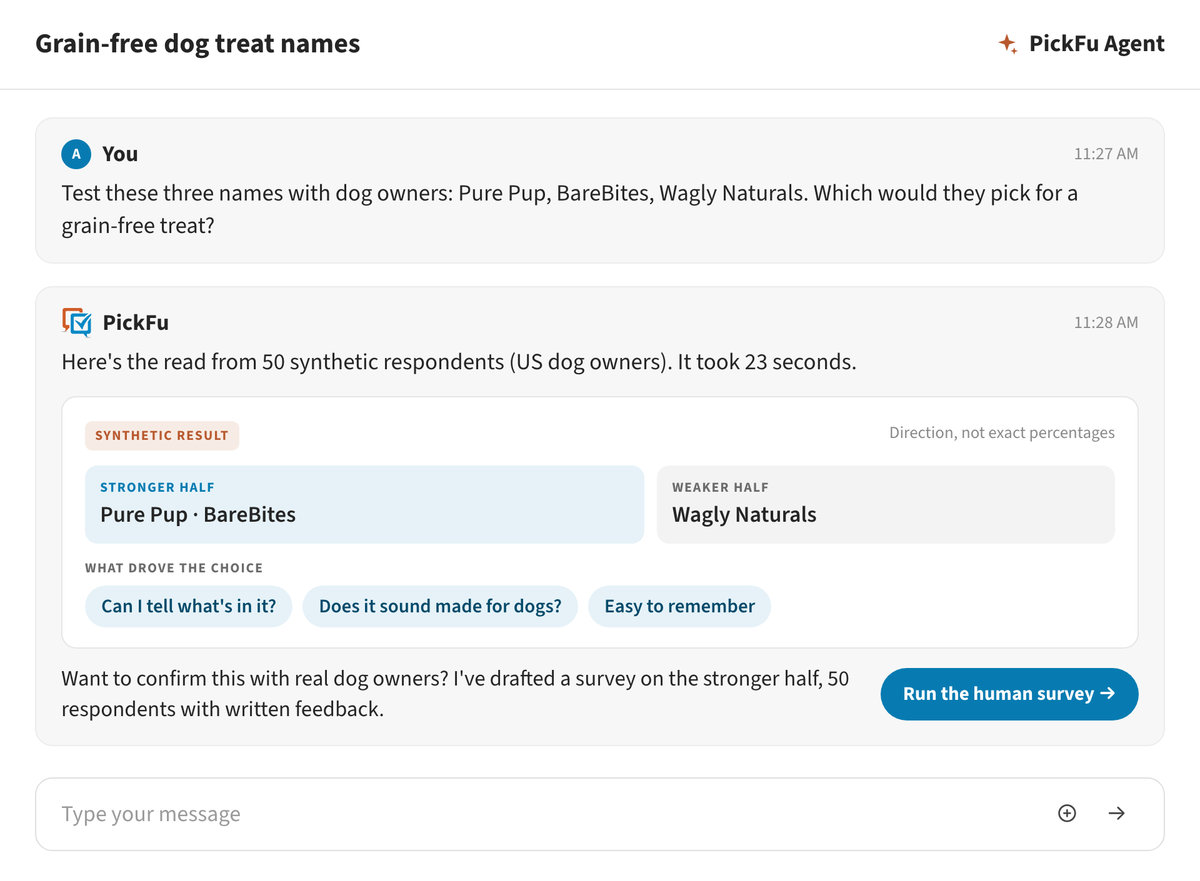
一个问题加 2–10 个选项,文字或图片均可。您会得到较强和较弱的两组选项、分歧背后的主题,以及每位合成受访者的一句话理由。
单概念测试
一个想法加一个开放式问题。您会得到一份摘要、主要主题、各细分群体的分歧点,以及值得继续追问的问题。
两天之内,我为两本非虚构类图书跑了一百多次合成测试。我根据第一轮的发现重做了封底,当天下午就再测了一次,调研因此成了写作过程的一部分,而不是最后才下的判决。价值更多在于理由,而不是排名。它还给了我一份简短而具体的清单,告诉我在提案发出前该把哪些问题交给 PickFu 的真人受访者样本库。
合成测试的强项
合成受访者在某些任务上确实很强,在另一些则不然。下面是我们的坦诚划分。
先用 Synthetic Audiences
- 把长名单缩到值得用真实用户测试的少数几个
- 文字对比:名称、标题、标语、卖点、价格
- 早期想法,以及内容、功能、清晰度和信任问题
- 选项差异明显的图片对比
交给真实用户
- 审美判断,以及任何真正全新的东西
- 涉及情绪的问题:金钱、健康、身份认同
- 成本高或难以回头的决策,比如最终包装
- 需要实际差距、逐条反馈,或要向买手或投资人出示证据时
为什么可以信任这些结果
我们的合成受访者基于真实消费者数据构建,同时我们也同样坦诚地说明它们的不足。
以真实用户为基准校验
我们会重放已知真实用户选择结果的历史问卷,并以此评估合成受访者。我们能做到这一点,是因为我们运营着真人受访者样本库。
坦诚说明局限
合成受访者擅长文字,在图片和情绪方面较弱。结果只显示较强和较弱的两组选项,我们也会提醒您:方向比差距大小更可信。
绝不与真人结果混合
只有在您主动要求时才会运行合成测试,而且每份结果都会标注为合成结果。我们绝不会把合成问卷或结果与真人问卷或结果合并。
常见问题
这会取代 PickFu 的真人受访者小组吗?
不会。我们的真人受访者不会消失,而且合成受访者正是以他们为原型构建的。合成方式帮你决定要测什么,真实用户帮你决定要怎么做。我们对合成结果的信心来自真人受访者样本库,因为那正是我们用来校验它的基准。
这和直接问 ChatGPT 有什么区别?
让 ChatGPT 扮演狗主人,它只是在想象。PickFu 的合成受访者则基于真实狗主人在真实问卷中做出的实际选择构建,包括他们拒绝了什么。每个结果都是数十个独立预测汇总而成,而不是某个模型对“它觉得人们怎么想”的概括。因为我们运营真人受访者样本库,我们能测出它有多接近,而不只是口头声称。
它的准确度如何?
我们以数百份已知真实用户选择结果的 PickFu 历史问卷作为基准校验。在文字对比中,它大多数时候与真实用户选择相同,图片对比则稍差一些。产品仍在测试版阶段,我们会持续测试和调整模型。
解读结果时有两点需要注意。它的差距比真人结果更大,所以如果您查看精确的票数分布,请更相信方向,而不是差距的大小。另外,单个受众的准确度尚未经过验证,因此我们不会为某一个受众给出具体数字。
什么时候应该使用合成受访者而不是真人?
用合成方式缩小范围,用真实用户做决定。合成反馈快速,而且在测试版期间限时免费,因此特别适合筛选长名单——把八个名字缩到值得测试的两个——或者对一个粗略概念做早期判断。
当决策成本高、难以改变,或属于纯审美、涉及情绪、完全全新的领域时,请交给真实受访者。当你需要的是实际差距而不只是方向时,也同样如此。
费用是多少?
目前完全免费。在 Synthetic Audiences 测试版期间,合成测试限时免费。如果您接着针对表现更强的选项发布真人问卷,定价与其他 PickFu 问卷一致,并且会在发布前先向您展示价格并请您确认。
有哪些受众可供选择?
超过 300 个合成受众。其中营养补充、健康与家居、美妆个护、图书和食品生鲜的覆盖最深。每个类目都按人群标签和人口统计细分——比如宠物食品中的狗主人、每月读 4 本以上书的人、每天服用补充剂的人——而不是笼统的“普通消费者”。
几点限制:目前受众仅支持美国,美国境内也没有地域细分,每次测试只能针对一个受众,我们暂时也无法基于您自己的客户或按需定制受众。如果您需要的受众还没有,请告诉我们——我们正是据此决定优先新增哪些受众。
我应该使用多少位合成受访者?
大多数测试用 30 到 50 位即可,上限是 75 位。超过 50 位之后,每多一位带来的增量很小,因为合成反馈会趋于一致。
每位合成受访者代表的是一类真实受访者,而不是某一个具体的人,所以你得到的是主题和规律,而不是个体差异。这也是更大样本量在这里意义不大的原因。
为什么同一个测试跑两次,结果数字不一样?
每次运行都会随机抽取一批全新的合成受访者,而背后的模型本身并非确定性的。较强与较弱选项的分组应该保持稳定,主题也是如此,但具体的票数分布会有变化。请把它当作方向,而不是精确测量。
我怎么知道真人反馈确实来自真人,而合成结果是分开的?
两者绝不会混在一起。只有当您通过 PickFu 智能体或 MCP 与 API 中的合成工具明确提出请求时,合成测试才会运行,而且返回的结果都会标注为合成结果。合成反馈不可能误入真人问卷,我们也从不把它们与真人结果合并。
每一条真人反馈都来自 PickFu 的受访者样本库,受访者需经过多层质量与身份核验,您还会收到每位受访者的文字回答和人群分布信息。
我的问卷数据会被用来构建合成受访者吗?
不会以可识别的形式使用。合成受访者基于受访者的作答历史构建,而问卷和受访者 ID 在进入模型之前都会先哈希处理,因此合成受访者背后的任何数据都无法追溯到您的问卷。您的结果绝不会分享给受访者或其他客户。PickFu 可能会使用问卷数据来改进自己的产品。
现在可以使用吗?
可以。Synthetic Audiences 目前处于测试版,向所有 PickFu 用户开放,限时免费。免费注册或登录后,即可通过 PickFu 智能体或 PickFu MCP 运行合成测试。